---
# Só mude aqui!!!!
author: "Marcus Fillipe e Gustavo Daudt"
title: "Relatório 01 - Fundamentos Iniciais da Linguagem R e Estatística Básica"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
#css: styles.css
code-fold: true
code-tools: true
code-copy: true
code-overflow: wrap
execute:
echo: true
warning: false
message: false
---
```{=html}
<style>
body { line-height: 1.7; }
h2 { margin-top: 2.6rem; color: #1e3d59; }
h3 { margin-top: 2rem; color: #284b63; }
h4 { margin-top: 1.5rem; }
p { margin-bottom: 1rem; }
.callout { margin: 1.4rem 0; border-radius: 8px; }
.callout p:last-child { margin-bottom: .35rem; }
div.sourceCode, pre { border-radius: 8px; }
pre { padding: 1rem; }
.cell { margin: 1.4rem 0; }
.cell-output-display { overflow-x: auto; }
table { width: 100%; margin: 1rem auto; }
thead { background-color: #edf3f8; }
</style>
```
## 📌 Introdução
O desenvolvimento das ferramentas computacionais modificou significativamente a maneira como dados científicos e experimentais são organizados, processados e analisados. Na Engenharia, a utilização de linguagens de programação e ambientes computacionais permite automatizar cálculos, manipular grandes conjuntos de informações, construir representações gráficas e implementar procedimentos matemáticos e estatísticos de maneira organizada e reprodutível.
Nesse contexto, destaca-se o R, uma linguagem de programação e ambiente computacional de código aberto inicialmente desenvolvido com forte orientação para a Estatística e a análise de dados. Entretanto, suas aplicações atualmente ultrapassam o cálculo estatístico, abrangendo manipulação de dados, programação, elaboração de gráficos, desenvolvimento de funções, produção de documentos científicos, construção de aplicações e integração com outras linguagens e tecnologias.
A utilização adequada do R requer mais do que o conhecimento de comandos isolados. É necessário compreender os princípios que estruturam a linguagem, a forma como os objetos são criados e armazenados, os diferentes tipos e estruturas de dados, o funcionamento das funções, os mecanismos de atribuição, as estruturas de controle, os ambientes de execução, o escopo léxico e a organização das funcionalidades por meio de pacotes. Esses conceitos permitem compreender não apenas como executar determinado procedimento, mas também como o R interpreta e organiza as instruções fornecidas pelo usuário.
Associado ao R, o RStudio constitui um Ambiente Integrado de Desenvolvimento — IDE (Integrated Development Environment) — que facilita a escrita, organização e execução dos códigos. Sua interface reúne editor de scripts, console, ambiente de objetos, histórico de comandos, arquivos, gráficos, pacotes e documentação, proporcionando uma estrutura adequada ao desenvolvimento de análises computacionais.
Outra característica importante do R é sua capacidade de expansão. A linguagem possui um amplo ecossistema de pacotes desenvolvidos para diferentes finalidades, além de permitir interfaces com outras linguagens e tecnologias computacionais. Dessa forma, o R pode ser compreendido não apenas como um programa destinado ao cálculo estatístico, mas como um ambiente de programação capaz de integrar diferentes recursos em um mesmo fluxo de trabalho.
Entre suas principais aplicações encontra-se a análise estatística de dados. Na Engenharia Civil, resultados provenientes de ensaios de laboratório, levantamentos de campo e procedimentos de controle tecnológico apresentam variabilidade e necessitam ser organizados e interpretados. A Estatística Descritiva fornece recursos para essa finalidade por meio de distribuições de frequência, representações gráficas e medidas de posição, dispersão e forma.
Diante disso, o presente trabalho tem como eixo principal o estudo e a aplicação da linguagem R como ferramenta computacional, abordando seus fundamentos, estruturas de dados, funções, ambientes, pacotes e mecanismos de programação. Posteriormente, esses conhecimentos são empregados na implementação de procedimentos de Estatística Descritiva aplicados a dados relacionados à Engenharia Civil, utilizando o ambiente RStudio e o pacote leem. Busca-se, assim, relacionar os fundamentos da programação em R à resolução computacional de um problema técnico de Engenharia.
## 🎯 Objetivos
### Objetivo geral
Aplicar os fundamentos da Estatística Descritiva e da programação em R na análise de dados voltados à Engenharia Civil. A prática fundamenta-se nos quatro primeiros capítulos do livro *Estatística & Probabilidade Aplicada às Engenharias e Ciências (EPAEC)* de @batista2024epaec, integrando a teoria matemática à execução computacional por meio do pacote `leem`, visando a organização, representação e a discussão crítica de um estudo de caso prático.
### Objetivos específicos
- Introduzir os conceitos de base da linguagem R e do RStudio (sintaxe, semântica e gerenciamento de objetos), fundamentados tanto no livro de @Rbasico2022, quanto nas 26 vídeo-aulas do curso R Básico.
- Revisar os conceitos iniciais da estatística (população, amostra e variáveis), além da notação de somatórios (Capítulo 1 do EPAEC).
- Aplicar técnicas de coleta, organização, tabulação e apresentação gráfica de dados quantitativos (Capítulo 2 do EPAEC).
- Compreender as formulações matemáticas e o significado prático das principais Medidas de Posição: média, mediana e moda (Capítulo 3 do EPAEC).
- Compreender e calcular as Medidas de Dispersão: amplitude, variância, desvio padrão, coeficiente de variação e erro padrão (Capítulo 4 do EPAEC).
- Pesquisar, definir e implementar o cálculo das Medidas de Forma (Assimetria e Curtose), interpretando o formato das distribuições estatísticas.
- Utilizar o pacote `leem` para estruturar um banco de dados de Engenharia Civil (Controle de Compactação de Solos), gerando análises numéricas e gráficas exequíveis.
- Discutir o diagnóstico de engenharia gerado pelos dados, avaliando o atendimento a critérios de projeto e a qualidade de execução de um serviço hipotético.
***
## 📚 Fundamentação Teórica
### A linguagem e o ambiente computacional R
O R é uma linguagem de programação e um ambiente computacional de código aberto utilizado para manipulação, processamento, análise e representação de dados. Embora apresente forte relação histórica com a Estatística, sua estrutura permite desenvolver aplicações que envolvem programação, cálculos numéricos, visualização, produção de documentos e integração com outras tecnologias.
O desenvolvimento do R teve início na década de 1990 a partir dos trabalhos de Ross Ihaka e Robert Gentleman, na Universidade de Auckland, na Nova Zelândia, apresentando influência da linguagem S. Posteriormente, seu desenvolvimento passou a ocorrer de maneira colaborativa, com participação do R Core Team e de uma ampla comunidade de usuários e desenvolvedores.
Uma característica importante do R é seu caráter aberto e extensível. Além das funcionalidades disponibilizadas em sua instalação, novos recursos podem ser incorporados por meio de pacotes, permitindo que pesquisadores e desenvolvedores disponibilizem funções, dados e métodos específicos para diferentes áreas do conhecimento.
Grande parte desses pacotes é distribuída pelo CRAN (Comprehensive R Archive Network), que constitui uma das principais estruturas de distribuição do R e dos pacotes associados ao seu ecossistema.
Dessa forma, o R pode ser compreendido simultaneamente como uma linguagem de programação, por possuir sintaxe, funções e estruturas próprias, e como um ambiente computacional, por fornecer mecanismos destinados à criação e manipulação de objetos, execução de procedimentos, gerenciamento de pacotes e integração com outras ferramentas.
### R e RStudio
Embora frequentemente utilizados de maneira conjunta, R e RStudio não correspondem à mesma ferramenta. O R é responsável pela interpretação e execução das instruções da linguagem, enquanto o RStudio fornece uma interface destinada a facilitar a interação do usuário com esse ambiente.
O RStudio é classificado como uma IDE — Integrated Development Environment, ou Ambiente Integrado de Desenvolvimento. Sua principal função é reunir em uma mesma interface diferentes recursos utilizados durante a programação.
Entre seus principais componentes encontram-se:
- editor de scripts: utilizado para escrever, organizar e armazenar códigos;
- console: local em que os comandos são interpretados e executados pelo R;
- Environment: apresenta os objetos existentes no ambiente de trabalho;
- History: registra comandos executados durante a sessão;
- Files: permite navegar pelos arquivos e diretórios;
- Plots: apresenta as representações gráficas produzidas;
- Packages: auxilia no gerenciamento dos pacotes;
- Help: fornece acesso à documentação das funções e dos pacotes.
Essa organização facilita o desenvolvimento de análises mais extensas, principalmente quando os procedimentos precisam ser registrados, corrigidos, repetidos ou compartilhados.
::: {.callout-tip appearance="simple" icon="false"}
O uso do editor de scripts é particularmente importante. Embora os comandos possam ser digitados diretamente no console, o armazenamento do código em arquivos permite preservar a sequência das operações realizadas e executar novamente a análise quando necessário.
:::
### Princípios fundamentais do R
A estrutura da linguagem R pode ser compreendida a partir de três princípios fundamentais: objeto, função e interface. Esses princípios auxiliam na compreensão do comportamento da linguagem e estabelecem relações entre os diferentes conteúdos utilizados durante a programação.
#### Princípio do objeto
No R, praticamente todos os elementos manipulados podem ser tratados como objetos. Valores numéricos, textos, vetores, matrizes, listas, bancos de dados e funções podem ser associados a nomes e posteriormente recuperados ou modificados.
Por exemplo
```r
x <- 10
```
Nesse comando, o valor 10 corresponde a um objeto e x representa o nome associado a esse objeto no ambiente considerado.
::: {.callout-note appearance="simple" icon="false"}
Os objetos possuem características próprias, como tipo, comprimento, classe e atributos. Essas características determinam a forma como os dados são armazenados e como determinadas funções irão se comportar quando aplicadas a eles.
:::
#### Princípio da função
Outro princípio importante estabelece que as operações realizadas no R estão relacionadas a chamadas de funções.
Uma função pode ser entendida como um conjunto de instruções destinado à realização de determinada tarefa. De maneira geral, recebe informações de entrada, realiza um processamento e retorna determinado resultado.
Sua representação básica pode ser expressa por:
```r
nome_funcao(argumentos)
```
pode ser representado por:
```r
`+`(10, 20)
```
Essa característica evidencia a importância das funções na estrutura da linguagem.
#### Princípio da interface
O terceiro princípio está relacionado à capacidade do R de estabelecer interfaces com outras linguagens e sistemas computacionais.
O próprio funcionamento do R utiliza rotinas implementadas em linguagens como C e Fortran, principalmente em operações que demandam processamento numérico eficiente. Além disso, existem recursos que permitem integração com C++, Python e outras tecnologias.
Portanto, o R não constitui um ambiente computacional completamente isolado. Sua arquitetura permite aproveitar recursos desenvolvidos em diferentes linguagens e incorporá-los ao fluxo de trabalho.
### Sintaxe e semântica
A utilização de uma linguagem de programação exige o conhecimento de sua sintaxe e de sua semântica.
A sintaxe corresponde às regras que determinam como as instruções devem ser escritas. Uma expressão que não respeita essas regras pode produzir um erro e impedir sua interpretação.
A semântica, por outro lado, está relacionada ao significado da instrução. Um comando pode apresentar sintaxe válida e, ainda assim, produzir um resultado diferente daquele pretendido pelo usuário.
No console do R, o símbolo:
```r
>
```
indica que o sistema está preparado para receber uma instrução.
Quando uma expressão ainda não foi finalizada, pode aparecer:
```r
+
```
indicando que o R aguarda sua continuação.
Os comentários são introduzidos pelo símbolo:
```r
# Comentário
```
e não são executados pelo programa. Eles são utilizados para documentar o código e facilitar sua compreensão.
::: {.callout-important appearance="simple" icon="false"}
O R diferencia letras maiúsculas de minúsculas. Assim:
```r
idade
```
e:
```r
Idade
```
representam nomes diferentes.
:::
Existem também palavras reservadas da linguagem, como:
```r
if
else
for
while
function
```
que possuem significado específico dentro da sintaxe e não devem ser utilizadas de maneira inadequada como nomes de objetos.
### Objetos e atribuição
Para utilizar um resultado posteriormente, ele pode ser associado a um nome por meio de uma operação de atribuição.
Uma forma amplamente utilizada no R é o operador:
```r
<-
```
Por exemplo:
```r
grau_compactacao <- 97.2
```
Nesse caso, estabelece-se uma ligação entre o nome grau_compactacao e o objeto numérico correspondente ao valor 97.2.
Outro exemplo é:
```r
obra <- "Aterro Experimental"
```
em que o objeto criado apresenta conteúdo textual.
A atribuição é fundamental porque permite dividir uma análise em diferentes etapas. Um resultado pode ser calculado, armazenado em determinado objeto e posteriormente utilizado por outras funções.
A função:
```r
ls()
```
permite consultar os nomes dos objetos existentes no ambiente considerado.
### Tipos básicos de dados
Os objetos podem apresentar diferentes tipos internos, relacionados à maneira como seus valores são representados.
Entre os principais tipos utilizados no R encontram-se:
```text
logical;
integer;
double;
character;
complex;
raw.
```
O tipo logical representa valores lógicos:
```r
TRUE
FALSE
```
O tipo integer representa valores inteiros. A letra L pode ser utilizada para indicar explicitamente esse tipo:
```r
10L
```
Valores numéricos como:
```r
10.5
```
são normalmente representados como double.
O tipo character armazena sequências de caracteres:
```r
"Engenharia Civil"
```
As funções:
```r
typeof()
mode()
class()
```
podem fornecer diferentes informações sobre a natureza de determinado objeto.
::: {.callout-important appearance="simple" icon="false"}
É importante distinguir tipo, modo e classe, pois esses conceitos descrevem características diferentes do objeto e podem influenciar o comportamento das funções.
:::
### Valores especiais
O R também apresenta valores especiais utilizados para representar determinadas situações.
O valor:
```r
NA
```
indica, de maneira geral, um valor ausente.
O valor:
```r
NaN
```
representa resultados numéricos indefinidos, como determinadas operações matemáticas sem resultado numérico convencional.
Também podem ocorrer:
```r
Inf
-Inf
```
representando infinito positivo e negativo.
Por sua vez:
```r
NULL
```
representa a ausência de um objeto ou componente em determinados contextos e possui comportamento diferente de NA.
::: {.callout-warning appearance="simple" icon="false"}
Essa distinção é importante durante a análise de dados, especialmente porque valores ausentes podem interferir em cálculos estatísticos.
:::
Por exemplo:
```r
mean(x, na.rm = TRUE)
```
utiliza o argumento na.rm = TRUE para desconsiderar valores ausentes durante o cálculo da média.
### Estruturas de dados
Além dos tipos básicos, o R organiza os dados em diferentes estruturas, cada uma adequada a determinadas situações.
#### Vetores
Os vetores constituem uma das estruturas fundamentais da linguagem. Um vetor atômico reúne elementos de um mesmo tipo.
Pode ser criado utilizando:
```r
x <- c(10, 20, 30, 40)
```
A função c() combina os elementos em um vetor.
Outras formas de criação incluem:
```r
1:10
```
para produzir uma sequência, e:
```r
seq(0, 10, by = 2)
```
para criar sequências com intervalos especificados.
Também pode ser utilizada:
```r
rep(5, 3)
```
para repetir determinado elemento.
A seleção dos elementos é realizada por indexação:
```r
x[2]
```
retornando o segundo elemento.
Também podem ser selecionados vários elementos:
```r
x[c(1, 3)]
```
As operações com vetores são frequentemente vetorizadas. Por exemplo:
```r
x * 2
```
multiplica cada elemento do vetor por 2.
#### Matrizes
Uma matriz pode ser compreendida, em sua estrutura básica, como um vetor atômico associado a um atributo de dimensões.
Pode ser criada por:
```r
m <- matrix(
  1:6,
  nrow = 2,
  ncol = 3
)
```
A seleção utiliza dois índices:
```r
m[1, 2]
```
em que o primeiro representa a linha e o segundo a coluna.
O operador:
```r
%*%
```
é utilizado para multiplicação matricial, enquanto:
```r
*
```
realiza multiplicação elemento a elemento.
#### Arrays
Os arrays ampliam a organização matricial para mais de duas dimensões.
Por exemplo:
```r
a <- array(
  1:12,
  dim = c(2, 3, 2)
)
```
Nesse caso, a estrutura apresenta três dimensões e pode ser acessada por:
```r
a[linha, coluna, camada]
```
#### Listas
As listas diferenciam-se dos vetores atômicos por permitirem armazenar elementos de diferentes tipos e estruturas.
Por exemplo:
```r
ensaio <- list(
  identificacao = "P01",
  gc = c(96.5, 97.1, 98.0),
  aprovado = TRUE
)
```
Seus elementos podem ser acessados utilizando:
```r
ensaio$gc
```
ou:
```r
ensaio[[2]]
```
As listas possuem grande importância na linguagem porque diversas estruturas mais complexas são construídas a partir delas.
#### Data frames
Os data frames constituem uma das estruturas mais importantes para análise de dados.
Apresentam organização tabular, na qual normalmente:
- cada linha corresponde a uma observação;
- cada coluna corresponde a uma variável.
Exemplo:
```r
dados <- data.frame(
  ensaio = c("P01", "P02", "P03"),
  gc = c(96.5, 97.1, 94.8),
  aprovado = c(TRUE, TRUE, FALSE)
)
```
Uma característica importante é que diferentes colunas podem apresentar diferentes tipos de dados.
Uma variável pode ser acessada por:
```r
dados$gc
```
ou por indexação:
```r
dados[1, 2]
```
A estrutura data.frame possui especial importância na Estatística, pois representa de maneira natural conjuntos de observações e variáveis.
### Funções
As funções representam um dos elementos centrais da linguagem R. Uma função recebe argumentos, executa um conjunto de instruções e pode produzir determinado resultado.
Por exemplo:
```r
mean(x)
```
utiliza x como argumento para calcular a média.
As funções podem apresentar diversos argumentos:
```r
mean(x, na.rm = TRUE)
```
Nesse exemplo, na.rm modifica o comportamento da função ao indicar que valores ausentes devem ser removidos antes do cálculo.
::: {.callout-tip appearance="simple" icon="false"}
Os argumentos podem ser fornecidos de maneira posicional ou pelo nome. A identificação pelo nome pode melhorar a legibilidade quando a função apresenta diversos parâmetros.
:::
### Criação de funções próprias
O usuário também pode desenvolver suas próprias funções utilizando:
```r
function()
```
::: {.callout-tip appearance="simple" icon="false"}
Por exemplo:
```r
calcular_cv <- function(media, desvio_padrao) {
  100 * desvio_padrao / media
}
```
Posteriormente:
```r
calcular_cv(97.1, 1.5)
```
executará as instruções definidas no corpo da função.
:::
Uma função criada no R apresenta três componentes particularmente importantes:
- argumentos;
- corpo;
- ambiente associado à sua definição.
::: {.callout-note appearance="simple" icon="false"}
O resultado da última expressão avaliada pode ser retornado automaticamente. Também é possível utilizar explicitamente:
```r
return()
```
quando isso contribui para a lógica da função.
:::
As funções podem ainda ser anônimas, ou seja, utilizadas sem que seja necessário associá-las previamente a um nome.
### Estruturas de controle
As estruturas de controle modificam o fluxo de execução de acordo com determinadas condições.
A estrutura:
```r
if (condicao) {
  comando
}
```
executa determinado bloco quando a condição é verdadeira.
Quando existem duas alternativas, pode-se utilizar:
```r
if (condicao) {
  comando_1
} else {
  comando_2
}
```
Para operações vetorizadas, `ifelse()` pode ser utilizado em determinadas situações:
```r
classificacao <- ifelse(
  grau_compactacao >= 95,
  "Atende",
  "Não atende"
)
```
Também existem estruturas de repetição.
O `for` percorre elementos de uma sequência:
```r
for (i in 1:5) {
  print(i)
}
```
O `while` executa o bloco enquanto determinada condição permanecer verdadeira:
```r
i <- 1
while (i <= 5) {
  print(i)
  i <- i + 1
}
```
O `repeat` executa repetidamente um bloco até que exista uma condição explícita de interrupção, normalmente por break.
::: {.callout-note appearance="simple" icon="false"}
O comando `break` encerra o loop, enquanto `next` interrompe somente a iteração corrente e inicia a próxima.
:::
### Vetorização e encadeamento de operações
Uma característica importante do R é sua capacidade de executar operações diretamente sobre vetores e outras estruturas, reduzindo a necessidade de percorrer individualmente cada elemento.
Por exemplo:
```r
x <- c(10, 20, 30)
x * 2
```
produz:
```text
20 40 60
```
sem a necessidade de um for.
Além disso, diferentes funções podem ser encadeadas.
Uma forma tradicional é:
```r
sqrt(var(x))
```
Nesse caso, primeiro calcula-se a variância e, posteriormente, sua raiz quadrada.
Também é possível armazenar resultados intermediários:
```r
variancia <- var(x)
desvio_padrao <- sqrt(variancia)
```
Outra alternativa é utilizar o operador pipe:
```r
x |>
  var() |>
  sqrt()
```
::: {.callout-tip appearance="simple" icon="false"}
O `pipe` permite organizar sequências de operações de maneira linear, facilitando a leitura em procedimentos compostos por diversas etapas.
:::
### Escopo léxico e ambientes das funções
Quando uma função é executada, é criado um ambiente associado àquela chamada. Objetos criados dentro desse contexto normalmente permanecem locais à execução.
Se uma função utiliza um nome que não está disponível localmente, o R pode procurá-lo nos ambientes relacionados à definição da função. Esse mecanismo constitui o escopo léxico.
::: {.callout-tip appearance="simple" icon="false"}
Considere:
```r
x <- 10
f <- function() {
  x
}
```
Ao executar:
```r
f()
```
a função pode encontrar x no ambiente externo associado à sua definição.
:::
Esse comportamento permite que funções utilizem objetos existentes em ambientes envolventes e constitui uma característica fundamental para compreender funções mais complexas.
### Atribuição <- e superatribuição <<-
A atribuição:
```r
<-
```
é utilizada normalmente para criar ou modificar uma ligação no ambiente corrente.
O R também apresenta:
```r
<<-
```
denominado operador de superatribuição.
Esse operador procura uma ligação correspondente nos ambientes envolventes e modifica a primeira encontrada. Caso não encontre uma ligação apropriada na cadeia de ambientes, o comportamento pode resultar na criação de uma ligação no ambiente global.
Por exemplo, funções internas podem utilizar esse recurso para manter determinado estado entre diferentes chamadas.
::: {.callout-warning appearance="simple" icon="false"}
Apesar de útil em situações específicas, `<<-` deve ser empregado com cautela, pois pode modificar objetos existentes fora do ambiente local e tornar o comportamento do programa menos evidente.
:::
### Diretório de trabalho e scripts
O diretório de trabalho corresponde à localização utilizada como referência para leitura e gravação de arquivos.
Pode ser consultado por:
```r
getwd()
```
e alterado por:
```r
setwd("caminho")
```
::: {.callout-important appearance="simple" icon="false"}
O diretório de trabalho não deve ser confundido com o ambiente de objetos. O diretório corresponde a uma localização no sistema de arquivos, enquanto um ambiente mantém associações entre nomes e objetos durante a execução do R.
:::
Os códigos podem ser armazenados em arquivos de script com extensão:
`.R`
Essa prática permite executar novamente os procedimentos e facilita a correção, documentação e reprodução das análises.
Outro script pode ser executado por:
```r
source("arquivo.R")
```
Em trabalhos acadêmicos, o armazenamento adequado do código é fundamental para a reprodutibilidade computacional.
### Pacotes
Os pacotes são estruturas utilizadas para organizar e distribuir funções, conjuntos de dados, documentação e outros recursos.
Um pacote pode ser instalado utilizando:
```r
install.packages("nome_do_pacote")
```
Depois de instalado, pode ser carregado e anexado à sessão por:
```r
library(nome_do_pacote)
```
::: {.callout-important appearance="simple" icon="false"}
É importante diferenciar instalação e utilização na sessão. A instalação disponibiliza os arquivos do pacote no sistema. Já library() carrega os recursos necessários e anexa as funções exportadas ao caminho de busca.
:::
Pacotes podem ser obtidos principalmente pelo CRAN, embora também existam outras fontes de distribuição.
Em sua estrutura, podem existir elementos destinados aos códigos, documentação, metadados e controle das funções disponibilizadas aos usuários.
### Namespace e caminho de busca
Os pacotes utilizam namespaces para organizar suas funções e controlar quais objetos são disponibilizados externamente.
Uma função exportada pode ser acessada diretamente por:
```r
pacote::funcao()
```
Por exemplo:
```r
knitr::kable(dados)
```
Nesse caso, fica explícito que kable() pertence ao pacote knitr.
O operador:
```r
::
```
acessa objetos exportados pelo pacote sem a necessidade de anexá-lo ao caminho de busca.
### Interfaces com outras linguagens
A capacidade de estabelecer interfaces constitui uma das características importantes do R.
A integração com `Python` pode ser realizada por ferramentas específicas, como o pacote reticulate. Dessa forma, funções ou códigos desenvolvidos em Python podem participar de um fluxo de trabalho executado no R.
A integração com `C++` pode ser realizada por ferramentas como Rcpp, permitindo compilar rotinas e disponibilizar funções para utilização no R.
De maneira conceitual, essa integração pode ser representada por:
*R → interface → outra linguagem → processamento → resultado disponível no R.*
O R também apresenta recursos de comunicação com `Tcl/Tk`, que pode ser utilizado na construção de interfaces gráficas com janelas, botões, campos de entrada e outros componentes.
Além dessas linguagens, o ecossistema R permite integração com diferentes tecnologias utilizadas para produção de documentos, páginas e aplicações.
Essa capacidade demonstra que o R não deve ser entendido somente como um software para cálculos estatísticos, mas como um ambiente computacional extensível e integrável.
### Boas práticas de programação em R
A qualidade de um programa não depende somente de sua capacidade de produzir o resultado esperado. O código deve também apresentar características que facilitem sua leitura, manutenção e reprodução.
A utilização de nomes descritivos constitui uma das práticas mais importantes.
Por exemplo:
```r
grau_compactacao
```
é mais informativo do que:
```r
x
```
quando o objeto representa resultados de grau de compactação.
A indentação também auxilia na identificação da estrutura lógica:
```r
if (grau_compactacao >= 95) {
  classificacao <- "Atende"
} else {
  classificacao <- "Não atende"
}
```
Os comentários devem ser empregados para explicar decisões ou etapas relevantes:
```r
# Cálculo da média dos resultados válidos
gc_media <- mean(grau_compactacao, na.rm = TRUE)
```
Também é recomendável manter consistência no uso de espaços, operadores, parênteses, colchetes e chaves.
A organização adequada torna-se ainda mais importante quando o código é utilizado em um trabalho acadêmico, pois outras pessoas podem precisar compreender como os resultados foram produzidos.
### R, Quarto e reprodutibilidade
Além dos scripts tradicionais, o R pode ser utilizado em sistemas de publicação científica e técnica.
O Quarto permite integrar em um mesmo documento:
- *texto*
- *código*
- *equações*
- *tabelas*
- *gráficos*
- *resultados computacionais*
- *referências*
Arquivos com extensão:
```text
.qmd
```
podem conter blocos de código R que são executados durante a geração do documento.
Essa integração apresenta uma vantagem importante: o código responsável pela obtenção dos resultados permanece associado ao texto em que esses resultados são apresentados e discutidos.
Em um fluxo tradicional, o pesquisador poderia executar um cálculo separadamente e posteriormente copiar seu resultado para o relatório. Em um documento computacional reprodutível, o próprio código pode produzir o resultado utilizado no texto.
::: {.callout-tip appearance="simple" icon="false"}
Essa estrutura reduz inconsistências decorrentes da transferência manual de resultados e facilita a atualização do documento quando os dados ou procedimentos são modificados.
:::
### O R como ferramenta para análise estatística
Entre as diferentes aplicações do R, destaca-se sua utilização na análise estatística de dados.
A linguagem apresenta funções para cálculo de diferentes medidas. Por exemplo:
```r
mean(x)
median(x)
var(x)
sd(x)
min(x)
max(x)
```
permitem calcular, respectivamente, média, mediana, variância, desvio padrão, mínimo e máximo.
::: {.callout-important appearance="simple" icon="false"}
A análise computacional, entretanto, não substitui o conhecimento estatístico. O programa executa as operações especificadas, mas a seleção do procedimento adequado e a interpretação dos resultados dependem da compreensão dos conceitos envolvidos.
:::
Dessa forma, a aplicação estatística pode ser compreendida como uma sequência:
*dados → estruturação no R → processamento → resultado estatístico → interpretação técnica.*
No presente trabalho, essa relação é explorada utilizando dados associados à Engenharia Civil, de modo que os conceitos de programação estudados sejam empregados na resolução de um problema quantitativo.
### Conceitos fundamentais da estatística
#### População e Amostra
A população (**N**) corresponde ao conjunto de elementos que apresentam uma ou mais características de interesse para determinado estudo. Pode ser finita, quando seus elementos podem ser enumerados, ou infinita, quando isso não é possível.
A amostra (**n**)é uma parte da população selecionada para representar suas características. Quando todos os elementos da população são analisados, realiza-se um censo, não sendo necessária a utilização de procedimentos de inferência estatística.
Apresente os conceitos principais:
#### Classificação das variaveis
As variáveis representam as características que serão observadas ou medidas em uma pesquisa. Podem ser classificadas em:
**Qualitativas:** representam características ou categorias. Podem ser nominais, quando não possuem uma ordem natural, ou ordinais, quando apresentam uma hierarquia.
**Quantitativas:** representam valores numéricos. São discretas quando resultam de contagens e contínuas quando resultam de medições e podem assumir diferentes valores em determinado intervalo.
::: {.callout-warning appearance="simple" icon="false"}
É importante observar que números utilizados apenas como códigos ou identificadores não transformam uma variável qualitativa em quantitativa.
:::
### Notação de Somatório
A notação de somatório permite representar, de forma compacta, a soma de vários valores e é utilizada em diversas fórmulas estatísticas. O índice indica a posição das observações e o limite superior determina até onde a soma será realizada.
$$
\sum_{i=1}^{n} x_i = x_1+x_2+x_3+\cdots+x_n
$$
::: {.callout-important appearance="simple" icon="false"}
Uma distinção importante é entre o somatório dos quadrados e o quadrado do somatório. No primeiro caso, cada valor é elevado ao quadrado antes da soma; no segundo, os valores são somados e somente depois o resultado é elevado ao quadrado.
:::
O somatório também apresenta propriedades algébricas que facilitam a manipulação das expressões estatísticas, como a possibilidade de retirar constantes do somatório e distribuir a operação sobre somas ou diferenças.
::: {.callout-note appearance="simple" icon="false"}
Uma propriedade importante é que a soma dos desvios em relação à média é igual a zero. Por isso, medidas de dispersão utilizam o módulo ou, principalmente, o quadrado dos desvios para evitar o cancelamento entre valores positivos e negativos.
:::
### Organização dos dados e Distribuição de Frequências
Os dados obtidos diretamente de uma pesquisa são denominados dados brutos. Antes da análise, é necessário organizá-los de forma adequada.
O rol consiste na ordenação dos dados, geralmente em ordem crescente ou decrescente. Essa organização facilita a identificação dos menores e maiores valores e é necessária para o cálculo de medidas como a mediana.
A frequência absoluta representa o número de vezes que determinado valor ou categoria ocorre. A frequência relativa expressa essa ocorrência em proporção ao total de observações, enquanto a frequência percentual apresenta o mesmo resultado em porcentagem.
As frequências acumuladas permitem identificar a quantidade de observações que se encontra abaixo ou acima de determinado valor ou classe.
Para variáveis contínuas, os dados podem ser agrupados em intervalos de classe, facilitando sua apresentação e interpretação. A construção das classes envolve a definição do número de classes, da amplitude total, da amplitude dos intervalos, dos limites e do ponto médio de cada classe. Após essa definição, são calculadas as respectivas frequências.
### Medidas de Posição
As medidas de posição permitem representar um conjunto de dados por meio de um valor central ou representativo. As principais são média, mediana e moda.
#### Média aritmética
A média aritmética é obtida pela soma dos valores observados dividida pelo número de observações. É amplamente utilizada em análises estatísticas, principalmente quando os dados apresentam distribuição aproximadamente simétrica e não possuem valores discrepantes.
$$
\bar{x} = \frac{1}{n}\sum_{i=1}^{n}x_i
$$
Quando os dados estão organizados em uma tabela de frequências, a média pode ser calculada considerando a frequência de cada valor ou o ponto médio das classes.
A média também apresenta propriedades importantes: a adição ou subtração de uma constante altera seu valor na mesma proporção, enquanto a multiplicação ou divisão por uma constante modifica a média pelo mesmo fator.
#### Média Aparada
A média aparada é obtida após a retirada de uma determinada proporção dos maiores e menores valores. É uma alternativa à média tradicional quando existem valores extremos que podem influenciar significativamente o resultado.
$$
\bar{x}_{\text{aparada}}
=
\frac{1}{n-2k}
\sum_{i=k+1}^{n-k}x_{(i)}
$$
#### Mediana
A mediana corresponde ao valor que divide os dados ordenados em duas partes iguais, deixando aproximadamente 50% das observações abaixo e 50% acima. Por depender da posição dos valores, apresenta maior resistência à influência de valores extremos do que a média.
$$
Md = x_{\left(\frac{n+1}{2}\right)}
$$
Para dados agrupados em classes, a mediana é estimada por meio de interpolação dentro da classe que contém a posição central dos dados.
#### Moda
A moda corresponde ao valor ou categoria que apresenta maior frequência. Uma distribuição pode ser unimodal, quando possui uma única moda, ou apresentar duas ou mais modas.
Quando os dados estão agrupados em classes, a moda pode ser estimada a partir da classe modal, utilizando métodos específicos, como a fórmula de Czuber.
A relação empírica de Pearson também pode ser utilizada para estimar a moda a partir da média e da mediana em distribuições unimodais com assimetria moderada.
### Medidas de dispersão
As medidas de dispersão indicam o grau de variabilidade existente nos dados. Essa informação é importante porque conjuntos de dados podem apresentar médias semelhantes, mas diferentes níveis de dispersão.
#### Amplitude total
A amplitude total corresponde à diferença entre o maior e o menor valor observado. É uma medida simples e rápida, porém bastante influenciada por valores extremos.
$$
AT = x_{\max} - x_{\min}
$$
#### Soma de quadrados
A soma de quadrados representa a soma dos desvios quadráticos das observações em relação ao centro dos dados. Constitui uma etapa importante para o cálculo da variância e de outros procedimentos estatísticos.
$$
SQ = \sum_{i=1}^{n}(x_i-\bar{x})^2
$$
#### Variância
A variância mede a dispersão dos valores em relação à média. No caso de amostras, utiliza-se a correção pelos graus de liberdade, com divisão por n - 1, buscando obter um estimador não viesado da variância populacional.
$$
s^2 = \frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}
$$
Para dados agrupados, a variância pode ser calculada considerando as frequências e os pontos médios das classes.
#### Desvio padrão
O desvio padrão corresponde à raiz quadrada da variância e apresenta a vantagem de estar expresso na mesma unidade dos dados originais. Por isso, é uma das principais medidas de dispersão utilizadas em análises estatísticas e relatórios técnicos.
$$
s = \sqrt{\frac{\sum_{i=1}^{n}(x_i-\bar{x})^2}{n-1}}
$$
::: {.callout-note appearance="simple" icon="false"}
A adição ou subtração de uma constante aos dados não altera o desvio padrão. Já a multiplicação dos dados por uma constante altera o desvio padrão proporcionalmente e a variância pelo quadrado dessa constante.
:::
#### Coeficiente de variação
O coeficiente de variação representa a dispersão de forma relativa à média, permitindo comparar a variabilidade entre conjuntos de dados com diferentes escalas ou magnitudes. Valores menores indicam, em geral, maior homogeneidade dos dados.
$$
CV = \frac{s}{\bar{x}}\times100
$$
::: {.callout-warning appearance="simple" icon="false"}
Sua utilização deve ser feita com cautela, especialmente quando a média apresenta valores próximos de zero ou quando a variável não possui um zero absoluto significativo.
:::
#### Erro padrão da média
O erro padrão da média representa a variabilidade esperada da média amostral em relação à média da população. Seu valor diminui à medida que o tamanho da amostra aumenta, indicando que amostras maiores tendem a produzir estimativas mais estáveis.
$$
EP = \frac{s}{\sqrt{n}}
$$
Essa medida é utilizada em procedimentos de inferência estatística, incluindo intervalos de confiança e testes de hipóteses.
### Tópico Adicional: Medidas de Forma (Assimetria e Curtose)
Além do centro e do espalhamento, a estatística analisa a "silhueta" da distribuição geométrica dos dados.
#### Assimetria
Avalia o grau de distorção ou inclinação da curva de dados em relação a uma distribuição normal e perfeitamente simétrica. Utilizando o cálculo pelo 3º momento central, penaliza os desvios mantendo seus sinais positivos ou negativos:
$$
g_1 = \frac{\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^3}{\left[\sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^2}\right]^3}
$$
- $g_1 = 0$: Distribuição simétrica (média $\approx$ mediana).<br>
- $g_1 > 0$: Assimetria Positiva (cauda alongada para a direita, repuxada por valores altos).<br>
- $g_1 < 0$: Assimetria Negativa (cauda alongada para a esquerda, influenciada por valores baixos).
#### Curtose
Mede o grau de achatamento da distribuição e a espessura de suas caudas (frequência de valores extremos). O cálculo padrão subtrai o valor 3, padronizando a distribuição normal no zero:
$$
g_2 = \frac{\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^4}{\left[\frac{1}{n}\sum_{i=1}^{n}(x_i-\bar{x})^2\right]^2} - 3
$$
- $g_2 = 0$ (Mesocúrtica): Curva com espalhamento similar à normal.<br>
- $g_2 > 0$ (Leptocúrtica): Curva mais afunilada, com pico elevado e caudas "pesadas" (alta chance de outliers).<br>
- $g_2 < 0$ (Platicúrtica): Curva achatada, indicando dados amplamente dispersos próximos ao centro.
## ⚙️ Metodologia e Estudo de Caso
Foi utilizado o pacote computacional `leem` para os cálculos estatísticos, bem como para o agrupamento de classes, somatório de desvios e obtenção dos momentos centrais.
::: {.callout-note appearance="simple" icon="false"}
**Contexto do Estudo de Caso:**
Na construção de barragens e aterros estruturais, o **Grau de Compactação (GC)** é a principal variável tecnológica que atesta a segurança do maciço contra deformações e infiltrações.
O GC é a razão percentual entre a massa específica seca alcançada no campo e a massa específica seca máxima obtida no ensaio de Proctor em laboratório [@abnt_nbr7182].
* **Parâmetro de Projeto:** Conforme preconizado em norma, o ensaio de compactação deve resultar em, pelo menos, **$GC \ge 95\%$** para garantir uma compactação eficiente e adequada [@abnt_nbr7182].
* **Banco de Dados:** Foi coletado **50 resultados de ensaios** realizados ao longo de uma camada do maciço terroso.
:::
A seguir, importaremos os dados no RStudio, realizaremos a tabulação em frequências (Cap. 2), calcularemos a posição e dispersão (Caps. 3 e 4) e interpretaremos a forma (Assimetria e Curtose) para emitir um diagnóstico de engenharia sobre a liberação ou rejeição deste aterro.
### Inicialização e Entrada dos Dados
No ambiente profissional, grandes volumes de informações não são inseridos manualmente no código, mas importados de planilhas e bases de dados externas. Para este estudo de caso, os 50 resultados dos ensaios de campo foram previamente tabulados e armazenados em um arquivo com extensão `.csv` (valores separados por vírgula). O primeiro passo da análise consiste em utilizar o R para ler esse arquivo externo, extrair a coluna de interesse e transformar os dados em um objeto reconhecido pelo pacote estatístico.
```{r}
#| label: preparacao-dados
#| echo: true
#| warning: false
# Carregamento das bibliotecas de análise e formatação
library(leem)
library(knitr)

# Importação dos dados a partir do arquivo CSV
tabela_importada <- read.csv("dados_compactacao.csv")

# Extração da coluna de dados como um vetor numérico
grau_compactacao <- tabela_importada$Compactacao

# Utilização da função new_leem para classificar como variável contínua (2)
gc_leem <- new_leem(grau_compactacao, variable = 2)

# Reorganizando os 50 dados em 5 colunas de 10 linhas para exibição compacta
tabela_exibicao <- data.frame(
  matrix(grau_compactacao, ncol = 5, byrow = FALSE)
)

# Exibindo os dados brutos de forma formatada com a função kable
kable(
  tabela_exibicao,
  align = "c",
  col.names = c(
    "Ensaios 1 a 10",
    "Ensaios 11 a 20",
    "Ensaios 21 a 30",
    "Ensaios 31 a 40",
    "Ensaios 41 a 50"
  ),
  caption = "Base de Dados Importada - Grau de Compactação (%)"
)
```
### Tabulação de Frequências (Consciência do Processo)
Ao executar a função `tabfreq()`, o algoritmo busca o valor mínimo (93.9%) e o máximo (101.1%), define a Amplitude Total da amostra e utiliza equações empíricas (como a regra de Sturges $k \approx 1 + 3,322 \log n$) para encontrar um número ideal de classes de intervalo. Com as classes definidas, o algoritmo executa somatórios condicionais, contando quantas amostras caem dentro de cada intervalo.
```{r}
#| label: tabela-freq
#| echo: true
#| warning: false
# Geração e plotagem nativa da tabela de distribuição de frequências
tabela_gc <- tabfreq(gc_leem)

kable(
  tabela_gc$table,
  align = "c",
  caption = "Tabela de Distribuição de Frequência - GC (%)"
)
```
::: {.callout-warning appearance="simple" icon="false"}
A tabulação já nos adianta o primeiro alerta: embora a maior densidade dos dados ($F_i$) esteja bem alocada nas faixas superiores a 95%, existe uma parcela de ensaios que caiu nas classes mais baixas do conjunto.
:::
### Síntese Descritiva: Posição, Dispersão e Forma
Para validar o maciço, não basta olhar para a tabela. Precisamos quantificar matematicamente o comportamento através dos momentos estatísticos. O código abaixo automatiza as equações dos Capítulos 3 e 4.
```{r}
#| label: medidas
#| echo: true
# 1. Medidas de Posição: métodos do leem para o objeto gc_leem
# grouped = FALSE preserva o cálculo sobre os dados brutos.
# rounding = Inf evita arredondamentos intermediários.
gc_media <- mean(gc_leem, grouped = FALSE, rounding = Inf)
gc_mediana <- median(gc_leem, grouped = FALSE, rounding = Inf)

# 2. Medidas de Dispersão
gc_desvio <- leem::sdev(gc_leem, grouped = FALSE, rounding = Inf)
gc_var <- leem::variance(gc_leem, grouped = FALSE, rounding = Inf)

# cv() no leem 0.2.0 arredonda internamente a média e o desvio.
# A razão abaixo preserva a precisão dos resultados originais.
gc_cv <- 100 * gc_desvio / gc_media

# 3. Medidas de Forma: mesmos momentos centrais do código original.
# skewness() do leem calcula Pearson, não a assimetria por momentos.
# showkur() é ilustrativa; não calcula a curtose da amostra.
desvios <- grau_compactacao - gc_media
momento2 <- mean(desvios^2)
gc_assimetria <- mean(desvios^3) / momento2^(3/2)
gc_curtose <- mean(desvios^4) / momento2^2 - 3

# Consolidação dos Resultados
estatisticas_gc <- data.frame(
  Parâmetro = c(
    "Média (%)",
    "Mediana (%)",
    "Desvio Padrão (%)",
    "Variância (%²)",
    "CV (%)",
    "Assimetria",
    "Curtose"
  ),
  Resultado = round(
    c(
      gc_media,
      gc_mediana,
      gc_desvio,
      gc_var,
      gc_cv,
      gc_assimetria,
      gc_curtose
    ),
    3
  )
)

kable(
  estatisticas_gc,
  align = "c",
  caption = "Estatísticas Descritivas Consolidadas - GC"
)
```
::: {.callout-note appearance="simple" icon="false"}
**Análise Crítica dos Resultados:**
* **Centro Equilibrado:** O algoritmo obteve uma média de **97,14%** e mediana de **97,15%**. A proximidade quase exata dessas duas grandezas confirma que não há "puxões" fortes (outliers severos) dominando o centro dos dados.
* **Homogeneidade de Execução:** O Coeficiente de Variação (CV) foi extremamente baixo (**1,86%**). Tal valor atesta que a frota de maquinário (rolos compactadores, caminhões-pipa e motoniveladoras) executou o serviço com padrão uniforme de energia em quase toda a praça de trabalho.
* **Diagnóstico de Forma:**
* A **Assimetria levemente positiva (0,157)** indica uma distribuição quase simétrica, mas com uma ínfima tendência de cauda para a direita (algumas amostras com compactação excepcional puxando levemente a curva).
* A **Curtose negativa (-0,735)** revela uma distribuição platicúrtica. Ou seja, em vez de se concentrar aguda e perigosamente no centro, os dados estão distribuídos de forma mais constante, com caudas mais curtas, o que estatisticamente diminui a chance da ocorrência de desvios drásticos e isolados.
:::
### Apresentação Gráfica e Decisão de Engenharia
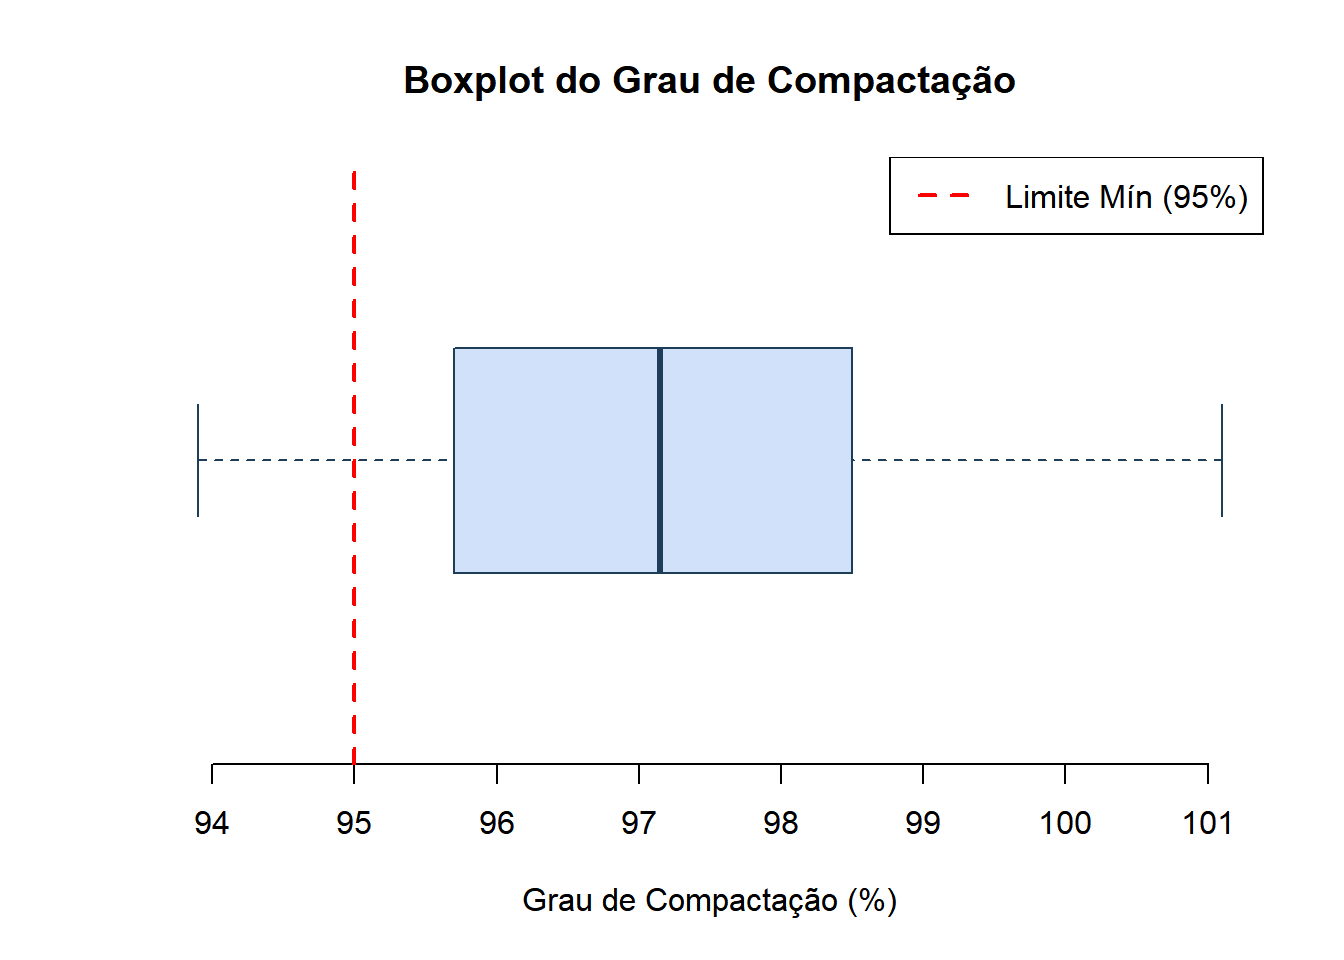
**Análise Gráfica de Dispersão e Outliers (Boxplot)**
Para validar visualmente as métricas de dispersão, assimetria e curtose calculadas anteriormente, a ferramenta estatística mais robusta é o *Boxplot* (Diagrama de Caixa). Ele segmenta os dados em quartis (blocos de 25% da amostra) e permite identificar imediatamente a presença de anomalias operacionais (*outliers*) e o achatamento da distribuição.
```{r}
#| label: grafico-boxplot
#| echo: true
#| fig-align: "center"
# Configuração do Boxplot pelo método do leem
boxplot(
  tabela_gc,
  type = "rawdata",
  details = FALSE,
  horizontal = TRUE,
  col = "#d0e1f9",
  border = "#1e3d59",
  xlab = "Grau de Compactação (%)",
  main = "Boxplot do Grau de Compactação"
)

# Adicionando o Limite de Especificação para referência
abline(v = 95.0, col = "red", lwd = 2, lty = 2)

legend(
  "topright",
  legend = "Limite Mín (95%)",
  col = "red",
  lty = 2,
  lwd = 2
)
```
::: {.callout-note appearance="simple" icon="false"}
* A linha escura que corta a caixa no meio representa a Mediana (97,15%). O fato de ela estar exatamente no centro do retângulo azul confirma uma *Assimetria quase nula*.
* O tamanho estreito da caixa retangular (que concentra os 50% centrais de todos os ensaios) comprova visualmente o baixo Coeficiente de Variação (CV). O maquinário compactou quase todo o material dentro de uma faixa de energia muito previsível.
* Os traços laterais (conhecidos como "bigodes") indicam as caudas da distribuição. Como estão curtos e não vemos pequenos pontos isolados para fora deles, confirmamos a *Curtose negativa*, ou seja, uma distribuição achatada e sem outliers caindo fora do padrão esperado.
:::
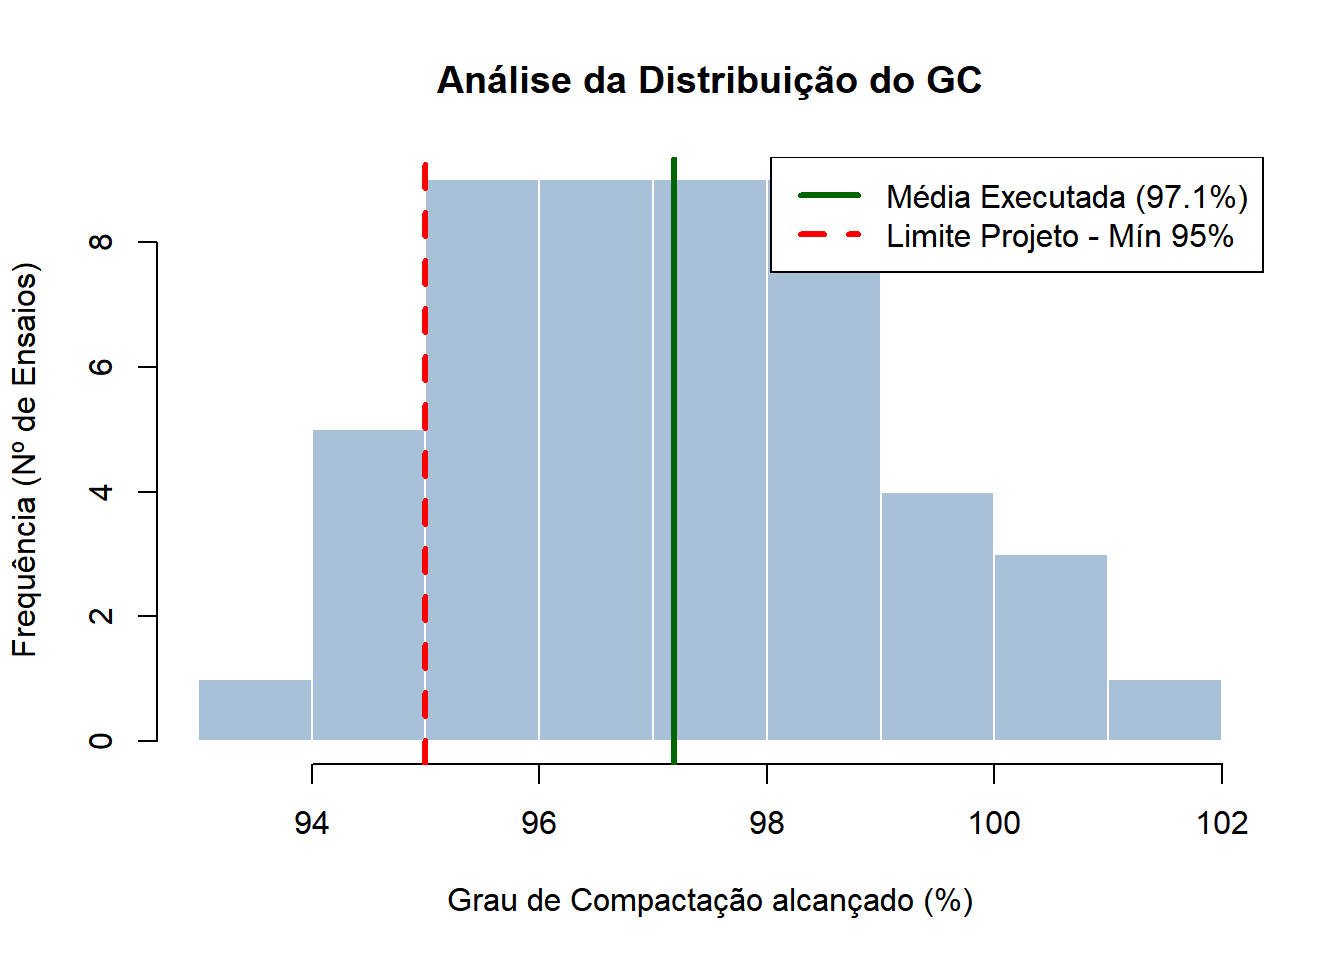
**Distribuição dos Dados**
O histograma sobreposto pelos limites de aceitação possui a resposta para a aprovação ou reprovação da camada pelo engenheiro fiscal.
```{r}
#| label: histograma
#| echo: true
#| fig-align: "center"
hist(
  grau_compactacao,
  breaks = 7,
  col = "#a8c0d8",
  border = "white",
  main = "Análise da Distribuição do GC",
  xlab = "Grau de Compactação alcançado (%)",
  ylab = "Frequência (Nº de Ensaios)"
)

# Marcadores Críticos de Tomada de Decisão
abline(v = 95.0, col = "red", lwd = 3, lty = 2) # Limite Mínimo de Projeto
abline(v = gc_media, col = "darkgreen", lwd = 3) # Desempenho Real

legend(
  "topright",
  legend = c(
    "Média Executada (97.1%)",
    "Limite Projeto - Mín 95%"
  ),
  col = c("darkgreen", "red"),
  lty = c(1, 2),
  lwd = 3
)
```
::: {.callout-important appearance="simple" icon="false"}
**O Veredito do Estudo de Caso:**
As representações gráficas consolidam o diagnóstico operacional. O *Boxplot* atesta a homogeneidade geral do serviço, comprovando que não existem *outliers* decorrentes de falhas graves de execução. Contudo, o histograma evidencia que o limiar de projeto (95%) intercepta a cauda inferior da distribuição, afetando o primeiro bloco de frequências.
Observando o banco de dados e a área sob o gráfico, constata-se que, apesar do serviço excelente na média (Média > 97% e CV baixíssimo), ocorreram **6 ensaios reprovados** (valores abaixo de 95%, perfazendo 12% da amostra). O engenheiro fiscal responsável não precisa rejeitar todo o lote, mas deve solicitar a **recompactação setorial** nos pontos específicos onde esses resultados foram obtidos. Essa intervenção é necessária para maximizar confiabilidade estrutural antes da liberação do aterro para a próxima camada.
:::
## 🧠 Considerações Finais
O presente relatório demonstrou a importância da Estatística Descritiva como ferramenta essencial para o controle de qualidade na Engenharia Civil. A revisão teórica embasou a aplicação computacional no RStudio com o pacote leem, comprovando que o uso de rotinas programadas otimiza o tratamento de dados e garante maior confiabilidade aos resultados, substituindo procedimentos manuais.
No estudo de caso sobre o Grau de Compactação, a aplicação integrada das medidas de posição, dispersão e forma foi determinante para a tomada de decisão. A análise restrita à média indicaria a aceitação total do serviço; porém, a avaliação da variância aliada ao histograma permitiu identificar desvios específicos, embasando a recomendação de correção pontual em 12% da área analisada. Assim, os objetivos da prática foram atingidos, evidenciando que o domínio conjunto de conceitos estatísticos e ferramentas computacionais é fundamental para análises técnicas mais seguras e criteriosas no canteiro de obras.
## 📖 Referências