---
# Só mude aqui!!!!
author: "Gustavo e Marcus Fillipe"
title: "Relatório 02 - Análise e Processamento de Base de Dados"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
---
## 📌 Introdução
O controle tecnológico do concreto é fundamental para garantir a qualidade e o desempenho das estruturas de concreto armado. Conforme a @abnt_nbr12655, esse controle envolve o acompanhamento das propriedades do concreto e a verificação de sua conformidade com os requisitos estabelecidos em projeto. Nesse contexto, a análise estatística dos resultados de ensaios e registros de campo constitui uma importante ferramenta para avaliar o comportamento do material e subsidiar decisões técnicas.
A confiabilidade dessas análises, entretanto, depende diretamente da qualidade dos dados utilizados. Bases provenientes de diferentes fontes podem apresentar valores ausentes, erros de digitação, inconsistências na representação numérica e ausência de padrão. O tratamento dessas inconsistências é, portanto, uma etapa essencial antes das análises.
Neste trabalho, é analisada uma base de dados de controle tecnológico do concreto, composta por observações reais e contendo informações relacionadas às propriedades e ao desempenho do material.
Para o processamento dos dados, utilizou-se a linguagem R, com ênfase nos recursos do Base R, abrangendo as etapas de inspeção, diagnóstico, limpeza, padronização e análise exploratória. Ao final, são obtidas estatísticas descritivas e criadas variáveis derivadas, permitindo avaliar o comportamento dos dados e gerar informações relevantes para a tomada de decisões na Engenharia Civil.
## 🎯 Objetivos
### Objetivo geral
Processar, limpar e analisar uma base de dados de controle tecnológico do concreto utilizando a linguagem R, identificando e tratando inconsistências e obtendo informações que contribuam para a avaliação do desempenho do material e para a tomada de decisões técnicas.
### Objetivos específicos
* Inspecionar a estrutura e as características da base de dados;
* Identificar valores ausentes, erros de registro e inconsistências;
* Padronizar e tratar as variáveis para a realização das análises;
* Aplicar recursos do Base R na manipulação e exploração dos dados;
* Calcular estatísticas descritivas e comparar diferentes grupos de dados;
* Criar variáveis derivadas relacionadas ao desempenho do concreto;
* Interpretar os resultados considerando sua aplicação na Engenharia Civil;
* Documentar os procedimentos realizados, garantindo maior organização e reprodutibilidade da análise.
## 📚 Fundamentação Teórica
### Análise e qualidade dos dados
A análise estatística de dados deve ser precedida por uma etapa de inspeção e verificação da qualidade das informações. A presença de valores ausentes, erros de digitação, categorias inconsistentes ou registros incompatíveis com o fenômeno estudado pode comprometer os resultados obtidos e conduzir a interpretações equivocadas.
Nesse contexto, a preparação dos dados compreende procedimentos de identificação, organização, correção e padronização das informações. A utilização de ferramentas computacionais, como o ambiente R, possibilita automatizar parte dessas etapas e permite maior rastreabilidade dos procedimentos realizados.
### Variáveis quantitativas e qualitativas
No contexto do controle tecnológico do concreto, resistência à compressão, consumo de cimento, abatimento, densidade, absorção, idade e relação água/cimento são exemplos de variáveis quantitativas (associadas a medidas). Já informações como bloco da obra e tipo de concreto são variáveis qualitativas (categorias).
A correta classificação das variáveis é fundamental. Uma variável quantitativa armazenada incorretamente como texto, por exemplo, impede cálculos matemáticos básicos no R, bloqueando a obtenção de médias e variâncias.
### Valores ausentes e tratamento dos dados
Valores ausentes (NA) ocorrem por falha na coleta ou erro de registro. A identificação deve ser prévia à análise. Entre as possibilidades de tratamento estão a exclusão da observação, imputação estatística ou a simples manutenção do NA. A escolha deve ser justificada, visto que alterações inadequadas podem introduzir vieses estruturais no laudo final.
### Estatística descritiva e análise agrupada
No controle tecnológico, a resistência média representa o comportamento central, mas deve vir acompanhada do desvio padrão e do coeficiente de variação para atestar a homogeneidade da execução. Além disso, a análise agrupada (por bloco, classe ou idade) permite identificar desvios de processo e comparar desempenhos em diferentes seções da obra, subsidiando a aceitação do lote.
### Relação água/cimento, consumo e idade
A resistência à compressão possui forte dependência da relação água/cimento (a/c), regida historicamente pela *Lei de Abrams* [@abrams1918]. Em condições comparáveis, o aumento da quantidade de água eleva a porosidade da matriz cimentícia, reduzindo substancialmente a resistência mecânica. Adicionalmente, o consumo de cimento e o tempo de cura (idade) interagem diretamente neste balanço, sendo esperado um ganho progressivo de resistência com o avanço da hidratação ao longo dos dias.
## ⚙️ Metodologia
### Inspeção e Estruturação
Inicialmente, a base de dados foi importada para o ambiente R atribuída ao objeto principal, utilizando funções nativas como `read.csv()`. A estrutura foi avaliada utilizando `dim()`, `str()` e `summary()`, permitindo o mapeamento inicial de variáveis mal classificadas (textos onde se esperavam números).
A função `head()` permitiu visualizar as primeiras observações, `dim()` permitiu verificar o número de linhas e colunas e `names()` apresentou os nomes das variáveis.
### Verificação dos valores ausentes
A existência de valores ausentes foi investigada utilizando:
```
sum(is.na(dados))
```
A quantidade de valores ausentes por variável foi obtida com:
```
colSums(is.na(dados))
```
Para localizar as posições dos valores ausentes, foi utilizado:
```
which(is.na(dados), arr.ind = TRUE)
```
### Investigação e Limpeza
A verificação de anomalias operou sobre duas frentes:
1. **Qualitativas:** Uso de `unique()` e `table()` para mapear espaços adicionais ("Bloco B ") e inconsistências de caixa ("c30" vs "C30").
2. **Quantitativas:** Mapeamento de problemas de digitação através de buscas textuais (letra "O" no lugar do zero, vírgulas no lugar de pontos) que forçavam a classificação para *character*.
Foi instanciada uma cópia denominada `dados_limpos` para preservar a integridade original. As correções ocorreram via `trimws()`, `toupper()`, `gsub()` e `as.numeric()`.
### Tratamento Analítico
A utilização de estruturas vetorizadas proporciona códigos mais concisos e adequados à lógica de funcionamento do R, facilitando a limpeza e a transformação de bases de dados complexas [@wickham2023r].
Os métodos de agrupamento e exploração envolveram as famílias de funções do Base R, como `aggregate()` para sumarizações multivariadas por grupos, e combinações de `split()`, `lapply()` e `sapply()` para isolar listas de dados. A avaliação iterativa foi feita comparando estruturas de controle (`for` e `if`) com funções vetorizadas mais eficientes (`ave()`).
### Criação da base limpa
Para preservar a base original, foi criada uma cópia denominada dados_limpos:
```
dados_limpos <- dados
```
As alterações necessárias foram realizadas somente no objeto dados_limpos.
Após as correções, a estrutura foi novamente verificada:
```
str(dados_limpos)
summary(dados_limpos)
```
### Correção dos tipos das variáveis
As variáveis quantitativas foram verificadas por meio da função `str()`.
Quando necessário, foram convertidas para o formato numérico utilizando `as.numeric()`:
```
dados_limpos$resistencia <- as.numeric(dados_limpos$resistencia`
```
Após a conversão, a estrutura foi novamente verificada:
```
str(dados_limpos)`
```
### Análise da resistência média
A resistência média geral foi calculada utilizando `mean()`:
```
mean(dados_limpos$resistencia, na.rm = TRUE)
```
O argumento `na.rm = TRUE` permite que os valores "NA" sejam desconsiderados no cálculo.
A resistência média por obra foi calculada utilizando `aggregate()`:
```
aggregate(`
  resistencia ~ obra,
  data = dados_limpos,
  FUN = mean,
  na.rm = TRUE
)
```
A resistência média por tipo de concreto foi obtida por:
```
aggregate(
  resistencia ~ tipo_concreto,
  data = dados_limpos,
  FUN = mean,
  na.rm = TRUE
)
```
E a resistência média por idade:
```
aggregate(
  resistencia ~ idade,
  data = dados_limpos,
  FUN = mean,
  na.rm = TRUE
)
```
### Utilização de `aggregate()`
Para calcular simultaneamente as médias das propriedades do concreto por tipo, foi utilizado:
```
aggregate(
  cbind(
    resistencia,
    consumo_cimento,
    relacao_a_c,
    abatimento,
    densidade
  ) ~ (tipo_concreto,
  data = dados_limpos,
  FUN = mean,
  na.rm = TRUE
)
)
```
Essa operação permitiu comparar as características médias das diferentes classes de concreto.
### Criação da variável `resistencia_relativa`
Foi criada a variável `resistencia_ref`, contendo os valores de referência de acordo com a classe do concreto.
Em seguida, foi criada a variável `resistencia_relativa`:
```
dados_limpos$resistencia_relativa <-
  dados_limpos$resistencia /
  dados_limpos$resistencia_ref
```
A variável representa a razão entre a resistência observada e a resistência de referência.
Valores superiores a 1 indicam resistência observada superior à referência, enquanto valores inferiores a 1 indicam resistência inferior à referência.
### Utilização de `split()`:
A base foi dividida de acordo com tipo_concreto utilizando:
```
grupos_concreto <- split(
  dados_limpos,
  dados_limpos$tipo_concreto
)
```
A quantidade de observações em cada grupo foi obtida utilizando:
```
sapply(grupos_concreto, nrow)
```
### Utilização de `lapply()` e `sapply()`:
A resistência média de cada grupo foi calculada utilizando `lapply()`:
```
medias_lapply <- lapply(
  grupos_concreto,
  function(x) {
    mean(x$resistencia, na.rm = TRUE)
 }
)
```
Posteriormente, a mesma operação foi realizada com `sapply()`:
```
medias_sapply <- sapply(
  grupos_concreto,
  function(x) {
    mean(x$resistencia, na.rm = TRUE)
 }
)
```
A principal diferença é que `lapply()` retorna uma lista, enquanto `sapply()` procura simplificar o resultado.
### Utilização de `apply()`:
As variáveis quantitativas foram selecionadas:
```
quantitativas <- dados_limpos[
  ,
  c(
    "resistencia",
    "consumo_cimento",
    "relacao_a_c"`
    "abatimento",
    "densidade",
    "absorcao"
  )
]
```
A média de cada variável foi calculada utilizando:
```
apply(
  quantitativas,
  2,
  mean,
  na.rm = TRUE
)
```
Também foi calculada uma medida resumo para cada observação:
```
apply(
  quantitativas,
  1,
  mean,
  na.rm = TRUE
)
```
Nesse segundo caso, deve-se destacar que a média obtida entre variáveis com diferentes unidades e significados físicos não possui necessariamente uma interpretação física direta.
### Utilização de `for` e `if`:
Para identificar os corpos de prova cuja resistência estivesse acima da média de sua classe, foi utilizada uma estrutura `for` combinada com `if`:
```
 for (i in 1:nrow(dados_limpos)) {

  classe <- dados_limpos$tipo_concreto[i]

  media_classe <- mean(
    dados_limpos$resistencia[
      dados_limpos$tipo_concreto == classe
    ],
    na.rm = TRUE
  )

  if (dados_limpos$resistencia[i] > media_classe) {

    print(dados_limpos[i, ])

  }
}
```
A mesma análise foi posteriormente realizada por meio de uma abordagem vetorizada.
A comparação entre as duas soluções considerou simplicidade, legibilidade e eficiência.
## 🔍 Resultados e Discussão
### Conhecendo a Base de Dados
O processamento iniciou-se com a importação do arquivo CSV. Utilizou-se o argumento `na.strings` para que o software reconhecesse automaticamente diferentes padrões de ausência de dados preenchidos pelos técnicos na planilha bruta.
```{r}
#| label: importacao-dados
#| echo: true
#| warning: false
library(knitr)

# Importação
dados <- read.csv2(
  "base_processamento_dados_engenharia_civil.csv",
  stringsAsFactors = FALSE,
  check.names = FALSE,
  na.strings = c("", " ", "NA", "N/A", "-", "null", "NULL")
)

# Dimensões estruturais da base
dimensoes <- data.frame(
  Caracteristica = c("Observações (Corpos de prova)", "Variáveis (Colunas)"),
  Quantidade = dim(dados)
)

kable(dimensoes, align = "c", caption = "Características Estruturais da Base Importada")
```
Ao aplicar a função `str()`, nota-se uma inconsistência crítica oriunda da coleta:
```{r}
#| label: estrutura-dados
#| echo: true
#| collapse: true
str(dados)
```
**Diagnóstico Inicial:** O software R classificou 9 das 10 variáveis como `chr` (Qualitativas/Texto) e apenas `idade_dias` como `int` (Quantitativa). Isso indica que colunas de natureza matemática (como resistência e consumo de cimento) foram contaminadas por letras ou caracteres de formatação durante a digitação. Consequentemente, a função `summary()` torna-se ineficaz nesta fase, pois não calcula métricas como médias ou quartis para dados textuais.
Em relação aos **Valores Ausentes**, mapeou-se a exata localização das lacunas:
```{r}
#| label: valores-ausentes
#| echo: true
# Contagem e localização de NAs
nas_totais <- colSums(is.na(dados))
tabela_na <- data.frame(Variavel = names(nas_totais), Faltantes = nas_totais)
tabela_na <- tabela_na[tabela_na$Faltantes > 0, ]

kable(tabela_na, align = "c", row.names = FALSE, caption = "Variáveis com Valores Ausentes (NA)")
```
Identificou-se a existência de 5 falhas de registro pulverizadas na base, afetando a resistência (CP-092), o abatimento (CP-015), a densidade (CP-077), a absorção (CP-097) e a relação a/c (CP-038).
### Investigação de Anomalias
Antes de transformar os dados, procedeu-se com a avaliação da coerência física. Ao analisar pontualmente os extremos da base, observou-se:
* **CP-032:** Abatimento registrado como 1250 mm (fisicamente incompatível, visto que o cone de slump possui 300 mm de altura).
* **CP-053:** Densidade de 238 kg/m³ (incoerente, pois o concreto normal varia entre 2300 a 2500 kg/m³, indicando provável supressão de um zero numérico).
* **CP-072:** Absorção de 18,4% (valor atípico para concreto estrutural, indicando erro de ensaio ou material não conforme).
A investigação de formatação revelou os erros de digitação:
```{r}
#| label: erros-digitacao
#| echo: true
# Localizando problemas clássicos de digitação
erros <- subset(dados, id_corpo_prova %in% c("CP-008", "CP-019", "CP-064"))
kable(erros[, c("id_corpo_prova", "resistencia_mpa", "cimento_kg_m3")], align = "c", row.names = FALSE)
```
Nota-se a presença de vírgulas ao invés de pontos (38,7) e da letra "O" maiúscula substituindo o zero numérico (3O,4 e 390O). É por este motivo que um **único valor digitado incorretamente altera a interpretação de toda a variável pelo software**: vetores no R exigem tipagem homogênea.
Para as variáveis categóricas, verificou-se a falta de padronização na nomenclatura:
```{r}
#| label: padronizacao-cat
#| echo: true
tabela_inconsistencias <- data.frame(
  Atributo = c("Obras Cadastradas", "Classes Cadastradas"),
  Registros_Unicos = c(paste(unique(dados$obra), collapse = " | "),
                       paste(unique(dados$tipo_concreto), collapse = " | "))
)
kable(tabela_inconsistencias, align = "l")
```
O `"Bloco B "` possui um espaço adicional no final, e a classe `"c30"` foi preenchida em letra minúscula, criando categorias redundantes e separadas no sistema.
### Procedimentos de Limpeza
A etapa de tratamento iniciou-se com a criação do objeto `dados_limpos`. Esta prática garante a rastreabilidade e a reprodutibilidade. Em caso de falha no algoritmo de tratamento, a base original bruta permanece preservada na memória.
A correção foi realizada em lote:
```{r}
#| label: limpeza-dados
#| echo: true
dados_limpos <- dados

# 1. Padronização de Categorias
dados_limpos$obra <- trimws(dados_limpos$obra) # Remove espaços excedentes
dados_limpos$tipo_concreto <- toupper(dados_limpos$tipo_concreto) # Força maiúsculas

# 2. Correção de Erros de Digitação e Coerção Numérica
colunas_corrigir <- c("resistencia_mpa", "cimento_kg_m3", "relacao_a_c")

for (col in colunas_corrigir) {
  dados_limpos[[col]] <- gsub("O", "0", dados_limpos[[col]]) # Troca letra O por 0
  dados_limpos[[col]] <- gsub(",", ".", dados_limpos[[col]]) # Troca vírgula por ponto
  dados_limpos[[col]] <- as.numeric(dados_limpos[[col]])     # Força transformação para numérico
}

# 3. Conversão das demais variáveis
dados_limpos$abatimento_mm <- as.numeric(dados_limpos$abatimento_mm)
dados_limpos$densidade_kg_m3 <- as.numeric(dados_limpos$densidade_kg_m3)
dados_limpos$absorção_agregado_pct <- as.numeric(dados_limpos$absorção_agregado_pct)
```
**Estratégia para Valores Ausentes:**
Excluir uma linha inteira devido à ausência exclusiva do parâmetro "abatimento" geraria perda estatística das demais variáveis válidas daquele corpo de prova. A imputação de dados artificiais na "resistência à compressão" introduziria um viés significativo na análise estrutural. Portanto, a decisão técnica adotada foi **manter o dado como NA (Not Available)**. Durante o cálculo estatístico, optou-se por utilizar o argumento `na.rm = TRUE` para ignorar esses espaços em branco apenas nas funções matemáticas restritas àquela coluna.
Com a base tratada, a função `summary` torna-se funcional:
```{r}
#| label: summary-limpo
#| echo: true
#| collapse: true
summary(dados_limpos[, c("resistencia_mpa", "cimento_kg_m3", "relacao_a_c")])
```
### Exploração Analítica
Restabelecida a tipagem matemática, procedeu-se com a extração das medidas descritivas:
```{r}
#| label: desempenho-bloco
#| echo: true
#| fig-align: "center"
# Agrupamento e ordenação
media_obras <- aggregate(resistencia_mpa ~ obra, data = dados_limpos, FUN = mean, na.rm = TRUE)
media_obras <- media_obras[order(-media_obras$resistencia_mpa), ]

# Lógica automática de cores
cores_barras <- rep("#E0E0E0", nrow(media_obras))     # Cinza claro para os irrelevantes
cores_barras[1] <- "#779ECB"                          # Azul escuro pastel para o maior
cores_barras[nrow(media_obras)] <- "#E0E0E0"          # cinza claro para o menor

cores_texto <- rep("#333333", nrow(media_obras))      # Texto escuro para as barras cinzas
cores_texto[1] <- "white"                             # Texto branco para a barra azul
cores_texto[nrow(media_obras)] <- "#333333"           # Texto escuro para a barra cinza

# Apresentação gráfica (salvando as posições x em 'bp')
bp <- barplot(media_obras$resistencia_mpa,
              names.arg = media_obras$obra,
              col = cores_barras,
              border = NA,
              main = "Resistência Média à Compressão por Bloco",
              ylab = "Resistência (MPa)",
              ylim = c(0, max(media_obras$resistencia_mpa) * 1.15))

# Adicionando os valores dentro das barras
text(x = bp,
     y = media_obras$resistencia_mpa - 2.5, # Posiciona o texto um pouco abaixo do topo
     labels = round(media_obras$resistencia_mpa, 1),
     col = cores_texto,
     font = 2) # font = 2 aplica negrito
```
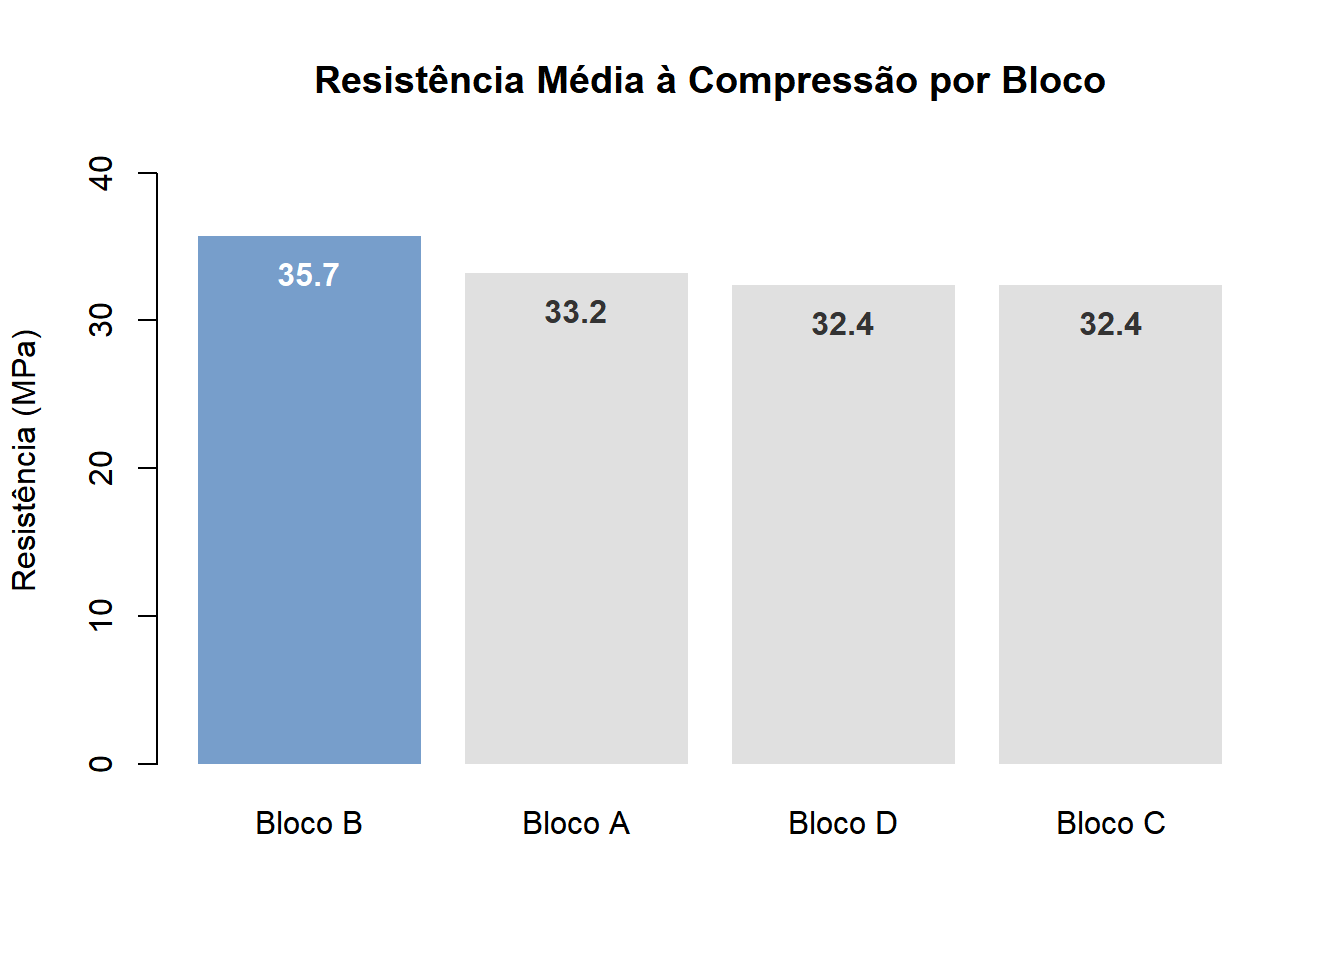
Constata-se que o **Bloco B** possui a maior resistência média (35,70 MPa), enquanto o **Bloco C** registrou a menor (32,37 MPa).
Para a análise unificada das propriedades tecnológicas, aplicou-se o `aggregate()` multivariado:
```{r}
#| label: aggregate-multivariado
#| echo: true
propriedades <- aggregate(
  cbind(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3) ~ tipo_concreto,
  data = dados_limpos,
  FUN = function(x) round(mean(x, na.rm = TRUE), 2)
)

kable(propriedades, align = "c", caption = "Resumo Tecnológico por Classe de Concreto")
```
Os dados consolidados demonstram expressiva coerência física. Concretos de maior classe (C40) demandaram maior consumo médio de cimento (404,12 kg/m³) aliado a um controle rigoroso de hidratação (relação água/cimento de 0,48), em pleno acordo com os fundamentos de dosagem.
### Criação de Variáveis Derivadas
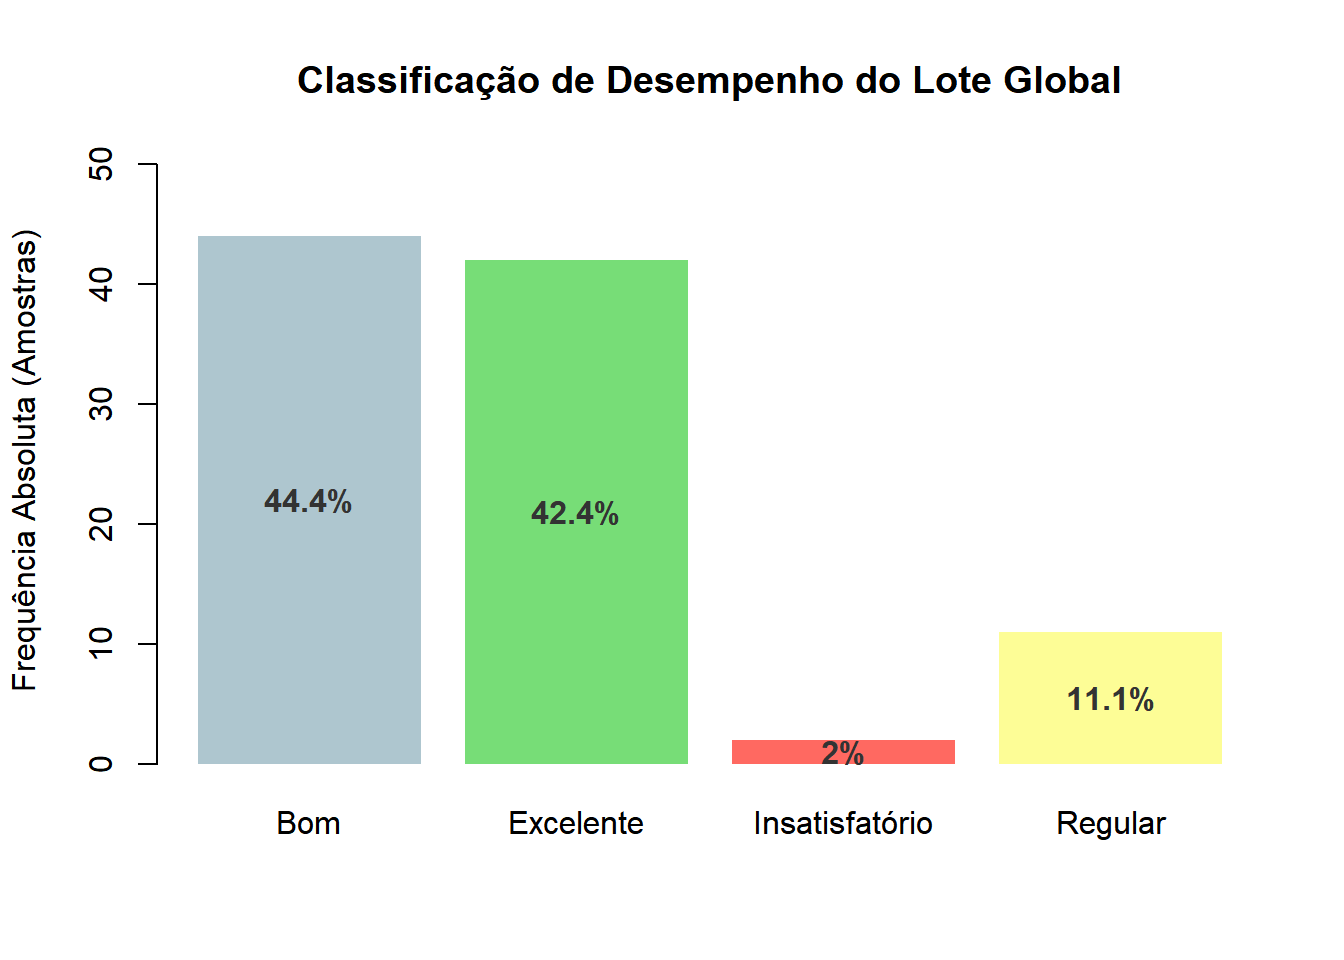
Foram criados indicadores relativos de eficiência. A `resistencia_relativa` foi indexada ao limite de projeto ($fck$) de cada classe: C25 (25 MPa), C30 (30 MPa), etc. A partir deste índice, classificou-se o lote e instituiu-se um validador lógico de desempenho superior à média:
```{r}
#| label: var-derivadas
#| echo: true
#| fig-align: "center"
# Indexadores de projeto
ref_fck <- c("C25"=25, "C30"=30, "C35"=35, "C40"=40)

# 1. Variável de Eficiência (Resistência Relativa)
dados_limpos$resistencia_relativa <- dados_limpos$resistencia_mpa / ref_fck[dados_limpos$tipo_concreto]

# 2. Qualificação do Desempenho Estrutural
dados_limpos$classificacao <- ifelse(is.na(dados_limpos$resistencia_relativa), NA,
                              ifelse(dados_limpos$resistencia_relativa >= 1.10, "Excelente",
                              ifelse(dados_limpos$resistencia_relativa >= 0.95, "Bom",
                              ifelse(dados_limpos$resistencia_relativa >= 0.85, "Regular", "Insatisfatório"))))

# 3. Verificador Condicional de Desempenho Acima da Média
dados_limpos$acima_media <- with(dados_limpos, resistencia_mpa > ave(resistencia_mpa, tipo_concreto, FUN = function(x) mean(x, na.rm=TRUE)))

# Apresentação visual da classificação
tab_classificacao <- table(dados_limpos$classificacao)

# Cores em tons pasteis correspondentes (Azul, Verde, Vermelho, Amarelo)
cores_pasteis <- c("#AEC6CF", "#77DD77", "#FF6961", "#FDFD96")

bp2 <- barplot(tab_classificacao,
               col = cores_pasteis,
               border = NA,
               main = "Classificação de Desempenho do Lote Global",
               ylab = "Frequência Absoluta (Amostras)",
               ylim = c(0, max(tab_classificacao) * 1.15))

# Calculando as porcentagens
pct <- round(prop.table(tab_classificacao) * 100, 1)
rotulos_pct <- paste0(pct, "%")

# Inserindo rótulos dentro das barras (no meio da altura de cada uma)
text(x = bp2,
     y = tab_classificacao / 2,
     labels = rotulos_pct,
     col = "#333333", # Cinza escuro contrasta perfeitamente com qualquer tom pastel
     font = 2)
```
O critério estabelecido considera índices relativos $>1,10$ como margem de segurança folgada (Excelente); entre 0,95 e 1,10 como Aceitável/Bom. Valores abaixo de 0,85 indicam necessidade de intervenção e avaliação de conformidade (Insatisfatório).
### Isolamento de Dados e Funções da Família Apply
O particionamento de bases longas é uma estratégia comum para análises em lote. Ao isolar os grupos de concreto e aplicar funções iterativas, testaram-se as abordagens de sumarização nativas do R:
```{r}
#| label: split-lapply
#| echo: true
# Isolamento por classe
grupos <- split(dados_limpos, dados_limpos$tipo_concreto)

# Teste com sapply
resultado_sapply <- sapply(grupos, function(x) mean(x$resistencia_mpa, na.rm = TRUE))

tabela_sapply <- data.frame(Classe = names(resultado_sapply),
                            Media_MPa = round(resultado_sapply, 2))

kable(tabela_sapply, align = "c", row.names = FALSE, caption = "Resistência Média extraída via sapply()")
```
A diferença estrutural central reside no formato de retorno. O `lapply()` devolve os cálculos confinados em objetos do tipo *lista*. O `sapply()`, por atuar como um simplificador de escopo, identifica que os retornos são números unitários e devolve um vetor limpo, configurando-se como uma opção mais pragmática para a formatação de tabelas e gráficos.
Avaliando o impacto transversal nas variáveis por meio da aplicação de matriz:
```{r}
#| label: fam-apply
#| echo: true
cols_quant <- dados_limpos[, c("resistencia_mpa", "cimento_kg_m3", "relacao_a_c", "abatimento_mm", "densidade_kg_m3")]

# Resumo por Linha (MARGIN = 1) - Primeiros 5 resultados
resumo_linhas <- apply(cols_quant, 1, mean, na.rm = TRUE)
tabela_linhas <- data.frame(Corpo_de_Prova = head(dados_limpos$id_corpo_prova, 5),
                            Media_Matematica_Bruta = round(head(resumo_linhas, 5), 2))

kable(tabela_linhas, align = "c", caption = "Cálculo Matemático Transversal (Sem significado físico)")
```
**Análise:** Quando a rotina computacional aplica o cálculo nas linhas (`MARGIN = 1`), ocorre a junção de grandezas físicas independentes e incompatíveis dimensionalmente (Mpa + Kg/m³ + mm). Portanto, embora o resultado numérico seja gerado pelo software sem erros de execução, **ele carece de validade física direta** ou interpretação plausível no campo da engenharia.
### Estruturas de Controle e Desempenho Algorítmico
Para o processo de identificação de corpos de prova situados acima da média global, comparou-se um algoritmo clássico (`for/if`) com a abordagem vetorizada nativa do R:
```{r}
#| label: for-if
#| echo: true
# Abordagem Tradicional (for / if)
acima_media_for <- logical(nrow(dados_limpos))
for (i in 1:nrow(dados_limpos)) {
  classe <- dados_limpos$tipo_concreto[i]
  media_classe <- mean(dados_limpos$resistencia_mpa[dados_limpos$tipo_concreto == classe], na.rm = TRUE)

  if (!is.na(dados_limpos$resistencia_mpa[i])) {
    acima_media_for[i] <- (dados_limpos$resistencia_mpa[i] > media_classe)
  } else {
    acima_media_for[i] <- NA
  }
}

# Abordagem Vetorizada (ave) executada na etapa 5:
# dados_limpos$acima_media <- dados_limpos$resistencia_mpa > ave(...)
```
A **Abordagem Vetorizada** (`ave`) demonstrou superioridade técnica pautada em dois fatores:
* **Simplicidade e Legibilidade:** Condensa 10 linhas lógicas de programação em uma única instrução limpa e direta.
* **Eficiência Computacional:** Executa os cálculos em linguagem de baixo nível de processamento por trás da interface do R, dispensando a necessidade de recalcular a média repetidas vezes de forma ineficiente durante os ciclos do *loop*.
### Avaliação de Premissas Profissionais
**Análise de Desempenho por Bloco**
A hipótese prévia de que o Bloco C detinha o melhor desempenho estrutural é refutada estatisticamente. Conforme demonstrado no Comparativo entre Blocos, o Bloco C obteve 32,37 MPa de média descritiva, sendo inferior ao Bloco B (35,70 MPa) e ao Bloco D (32,39 MPa).
**A Relação entre Cimento e Resistência**
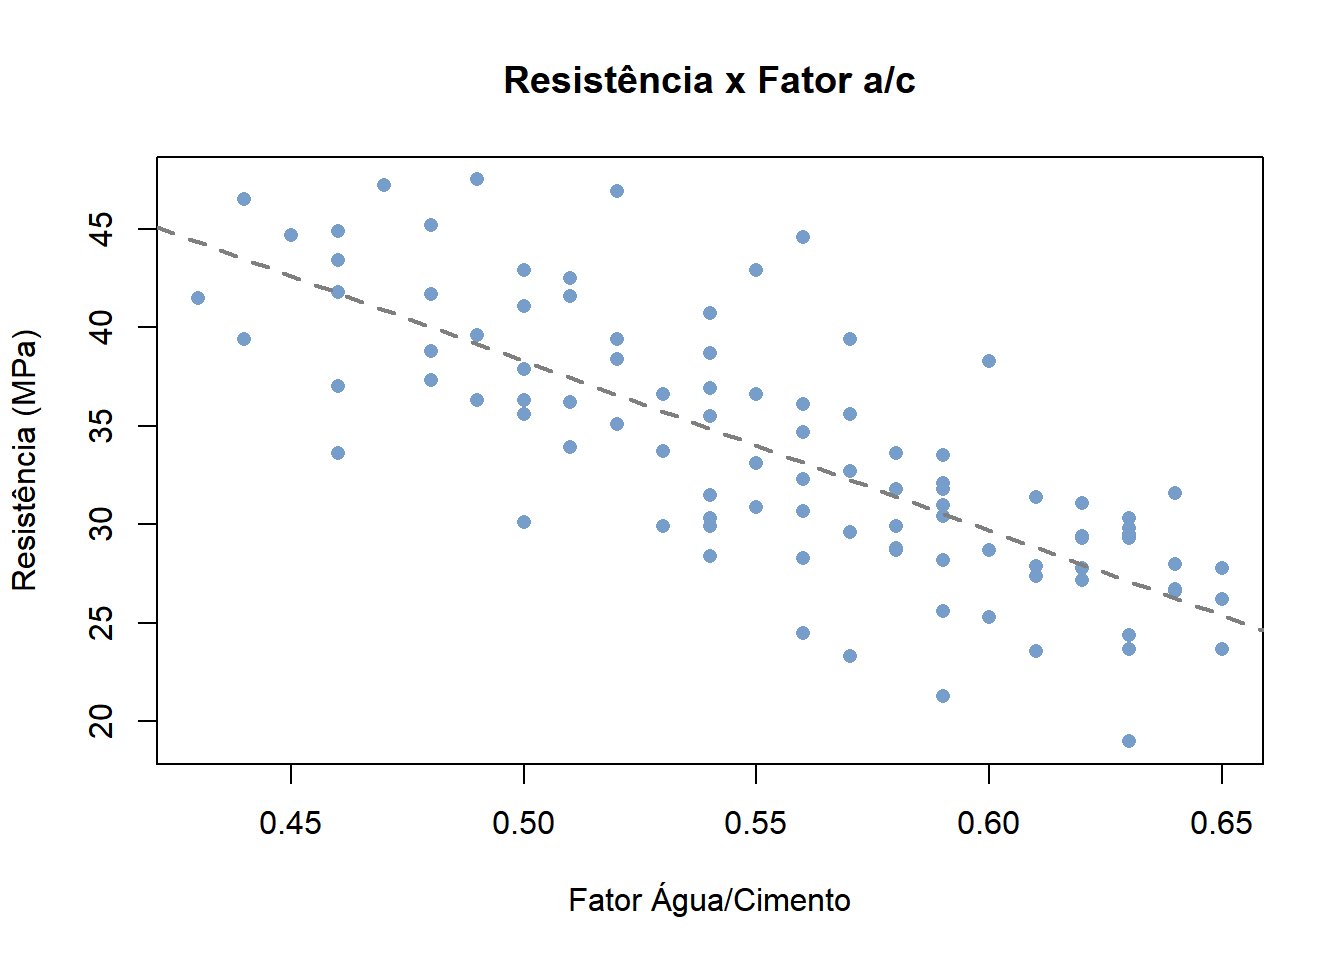
A suposição de que "quanto mais cimento, maior a resistência" de forma isolada revela-se inexata. Ao avaliar o cimento isolado da relação água/cimento, evidencia-se a importância das variáveis intervenientes:
```{r}
#| label: correlacoes
#| echo: true
#| fig-align: "center"
correlacoes_teste <- cor(dados_limpos[, c("resistencia_mpa", "cimento_kg_m3", "relacao_a_c")], use = "complete.obs")

# Plot a/c x resistência (bolinhas em azul escuro)
plot(dados_limpos$relacao_a_c, dados_limpos$resistencia_mpa,
     main = "Resistência x Fator a/c",
     xlab = "Fator Água/Cimento", ylab = "Resistência (MPa)",
     pch = 16, col = "#779ECB")

# Calculando e plotando a linha de tendência (tracejada cinza)
modelo_tendencia <- lm(resistencia_mpa ~ relacao_a_c, data = dados_limpos)
abline(modelo_tendencia, col = "gray50", lty = 2, lwd = 2)
```
A correlação simples de Pearson demonstra que a variável governante primária do ganho de resistência não se limita à massa de cimento (r = `r round(correlacoes_teste[1,2], 2)`), mas está fortemente atrelada à expressiva correlação negativa da **relação a/c** (r = `r round(correlacoes_teste[1,3], 2)`). Tal comportamento é a validação descritiva empírica da *Lei de Abrams* [@abrams1918]. O acréscimo de aglomerante sem o devido controle do volume hídrico não garante avanço na capacidade portante do material.
**Influência da Idade de Cura**
Os dados tabulados corroboram o amadurecimento progressivo das reações de hidratação:
```{r}
#| label: idades
#| echo: true
idade <- aggregate(resistencia_mpa ~ idade_dias, data = dados_limpos, FUN = function(x) round(mean(x, na.rm=TRUE), 2))
kable(t(idade), align = "c", caption = "Evolução temporal da Resistência Média (MPa)")
```
Observa-se um ganho acentuado entre 7 e 14 dias, seguido de uma estabilização na idade de controle normativo (28 dias) e um avanço residual e moderado no longo prazo (280 dias).
### Sumário Executivo para Tomada de Decisão (Top 5 Indicadores)
Para subsidiar a tomada de decisão do engenheiro responsável, o painel executivo a seguir consolida cinco indicadores estatísticos prioritários, calculados individualmente para cada classe de concreto. A interpretação conjunta dessas métricas permite uma avaliação completa e segura do controle tecnológico:
* **Resistência Média (MPa):** É o parâmetro primário para certificar se o lote está, em média, superando o limite característico (fck) exigido no projeto estrutural.
* **Fator Água/Cimento (A/C) Médio:** Atua como o principal balizador de resistência e durabilidade. O monitoramento contínuo deste índice garante o controle contra excessos de água na mistura, fator que comprometeria a porosidade do concreto.
* **Consumo de Cimento Médio (kg/m³):** Reflete a dosagem de aglomerante empregada na usinagem. A sua avaliação periódica é essencial tanto para o controle financeiro do traço quanto para prevenir patologias associadas à retração e ao calor de hidratação.
* **Coeficiente de Variação (%):** Quantifica a homogeneidade do processo executivo. Valores reduzidos comprovam que o maquinário manteve um padrão constante de mistura e adensamento, atestando um controle de qualidade rigoroso no canteiro.
* **Taxa de Qualidade Positiva (%):** Traduz a confiabilidade do lote para uma linguagem gerencial. Indica a proporção exata de corpos de prova que atingiram as margens de segurança adequadas (classificações Excelente ou Bom), balizando a aprovação final para a continuidade da obra.
Abaixo, apresenta-se a rotina computacional que extrai e consolida automaticamente esses parâmetros a partir da base tratada:
```{r}
#| label: top5-indicadores
#| echo: true
# Extração customizada e arredondamento para a Matriz Executiva
res_med <- tapply(dados_limpos$resistencia_mpa, dados_limpos$tipo_concreto, function(x) round(mean(x, na.rm=TRUE), 2))
ac_med <- tapply(dados_limpos$relacao_a_c, dados_limpos$tipo_concreto, function(x) round(mean(x, na.rm=TRUE), 2))
cv_pct <- tapply(dados_limpos$resistencia_mpa, dados_limpos$tipo_concreto, function(x) round((sd(x, na.rm=TRUE)/mean(x, na.rm=TRUE))*100, 2))
cim_med <- tapply(dados_limpos$cimento_kg_m3, dados_limpos$tipo_concreto, function(x) round(mean(x, na.rm=TRUE), 2))

# Taxa de conformidade de execução qualitativa
taxa_aprov <- tapply(dados_limpos$classificacao, dados_limpos$tipo_concreto, function(x) {
  validos <- na.omit(x)
  round((sum(validos %in% c("Excelente", "Bom")) / length(validos)) * 100, 2)
})

painel_executivo <- data.frame(
  Classe_do_Concreto = names(res_med),
  Resistencia_Media = as.numeric(res_med),
  Fator_AC_Medio = as.numeric(ac_med),
  Consumo_Cimento_Medio = as.numeric(cim_med),
  Coeficiente_de_Variacao = as.numeric(cv_pct),
  Taxa_Qualidade_Positiva = paste0(as.numeric(taxa_aprov), "%")
)

kable(painel_executivo, align = "c", caption = "Painel Executivo: Top 5 Indicadores Estratégicos por Classe")
```
### Desafio: Script Consolidado
Abaixo, encontra-se documentado o *script* centralizado recomendado para limpezas e geração ágil de relatórios em futuros recebimentos de material por parte da construtora:
```{r}
#| label: script-final
#| echo: true
#| eval: false
#| code-fold: false
# =======================================================
# SCRIPT DE PROCESSAMENTO: CONTROLE TECNOLÓGICO CONCRETO
# =======================================================

# 1. IMPORTAÇÃO
base_bruta <- read.csv2("base_processamento_dados_engenharia_civil.csv",
                        stringsAsFactors = FALSE, check.names = FALSE,
                        na.strings = c("", " ", "NA", "N/A", "-", "null", "NULL"))

# 2. INSPEÇÃO
str(base_bruta)
colSums(is.na(base_bruta))

# 3. LIMPEZA E FORMATAÇÃO
base_limpa <- base_bruta
base_limpa$obra <- trimws(base_limpa$obra)
base_limpa$tipo_concreto <- toupper(base_limpa$tipo_concreto)

colunas <- c("resistencia_mpa", "cimento_kg_m3", "relacao_a_c")
for (col in colunas) {
  base_limpa[[col]] <- as.numeric(gsub(",", ".", gsub("O", "0", base_limpa[[col]])))
}
base_limpa$abatimento_mm <- as.numeric(base_limpa$abatimento_mm)
base_limpa$densidade_kg_m3 <- as.numeric(base_limpa$densidade_kg_m3)

# 4. ESTATÍSTICAS DIRETAS
Resumo_Classes <- aggregate(cbind(resistencia_mpa, relacao_a_c) ~ tipo_concreto,
                            data = base_limpa, FUN = function(x) round(mean(x, na.rm = TRUE), 2))

# 5. VARIÁVEIS DERIVADAS
fcks <- c("C25"=25, "C30"=30, "C35"=35, "C40"=40)
base_limpa$relativo <- base_limpa$resistencia_mpa / fcks[base_limpa$tipo_concreto]
base_limpa$alerta_baixo <- ifelse(base_limpa$relativo < 0.95, "Alerta", "Aprovado")
```
## 🧠 Considerações Finais
A etapa de organização, diagnóstico e processamento apresenta-se como indispensável na Engenharia Civil guiada por dados. No ambiente real de obra e controle laboratorial, as planilhas encontram-se frequentemente suscetíveis a falhas humanas de digitação e ausências de registros. Negligenciar a etapa de limpeza e proceder diretamente à aplicação de algoritmos estatísticos pode fundamentar decisões técnicas errôneas, induzindo o profissional a aprovar lotes de materiais não conformes ou a rejeitar concretos viáveis.
O principal problema encontrado na base avaliada consistiu na contaminação dos registros numéricos por caracteres tipográficos (vírgulas utilizadas como separadores de milhar e a inserção da letra 'O' no lugar de zeros numéricos). Tal inconsistência estrutural provocou a coerção indevida da variável para o formato texto, inviabilizando inicialmente o cômputo matemático das métricas de resistência e dosagem. A decisão técnica para a mitigação desse problema centrou-se na execução de rotinas programadas em lote (via substituição de caracteres e refatoração numérica), restaurando o domínio computacional das variáveis. Paralelamente, adotou-se o rigor de manter as células vazias identificadas corretamente como `NA`, a fim de não inserir vieses analíticos nas estatísticas finais.
Ao término da verificação, os objetivos propostos foram devidamente atendidos. Validou-se, de forma descritiva e gráfica, o atendimento normativo da tipologia C40, a evolução de endurecimento conforme amadurecimento temporal das idades, além de aferir na prática os preceitos da Lei de Abrams. Demonstra-se, assim, que o uso de ferramentas nativas de manipulação vetorizada constitui não apenas suporte estatístico, mas um recurso validador crucial para deliberações logísticas e de conformidade em empreendimentos de grande porte.
## 📖 Referências