---
# Só mude aqui!!!!
author: "Marcus Fillipe e Gustavo Daudt"
title: "Relatório 03 - Processamento de Dados com Tidyverse"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
---
## 📌 Introdução
O controle tecnológico do concreto constitui uma etapa indispensável na Engenharia Civil, visando garantir a segurança estrutural e a conformidade dos materiais aplicados em obra. De acordo com os preceitos normativos, propriedades como resistência à compressão, relação água/cimento e consumo de aglomerante devem ser sistematicamente monitoradas. A análise estatística desses registros possibilita a avaliação do desempenho dos lotes, fundamentando deliberações de aceitação ou rejeição da estrutura.
No entanto, a validação dessas análises é condicionada à integridade dos dados coletados. Em cenários práticos de canteiros de obras e laboratórios, as informações são provenientes de múltiplas fontes e preenchidas por diferentes profissionais, tornando as planilhas suscetíveis a anomalias. Erros de digitação, inconsistências de formatação, valores discrepantes e dados ausentes são problemas comuns que, se não tratados, invalidam o cômputo matemático e distorcem o panorama estrutural.
O presente trabalho aborda o diagnóstico, a limpeza e o processamento de uma base de dados contendo ensaios de controle de concreto. Diferentemente de abordagens clássicas baseadas em funções nativas dispersas, adota-se prioritariamente o ecossistema `tidyverse` da linguagem R. Este paradigma propõe uma organização sequencial e encadeada da manipulação de dados, conferindo legibilidade e eficiência à transformação de planilhas brutas em métricas gerenciais confiáveis.
## 🎯 Objetivos
### Objetivo geral
Inspecionar, diagnosticar, limpar e explorar uma base de dados de controle tecnológico do concreto, utilizando o ecossistema `tidyverse` na linguagem R, com a finalidade de converter registros brutos em indicadores técnicos que auxiliem o processo de tomada de decisão na Engenharia Civil.
### Objetivos específicos
* Importar os dados experimentais preservando sua tipagem original para fins de auditoria;
* Empregar ferramentas exploratórias para identificar inconsistências categóricas, erros tipográficos e valores ausentes;
* Aplicar o fluxo de processamento de dados do pacote `dplyr` e `stringr` para a padronização unificada da base;
* Calcular medidas descritivas e indicadores de dispersão por meio de operações vetorizadas e agrupadas;
* Produzir visualizações gráficas com o pacote `ggplot2` para investigar associações entre parâmetros de dosagem e a resistência mecânica;
* Consolidar os procedimentos em um *script* reprodutivo, gerando um sumário executivo focado no acompanhamento de diferentes classes de concreto.
## 📚 Fundamentação Teórica
### Qualidade de Dados e Paradigma Tidyverse
A premissa fundamental da análise de dados postula que a qualidade do resultado estatístico é intrinsecamente dependente da integridade dos dados de entrada. Bases brutas necessitam de auditoria de consistência, visto que linguagens de programação, como o R, exigem tipagem homogênea em seus vetores. A presença de caracteres indevidos (como letras em meio a números) força a coerção estrutural para o formato de texto, bloqueando operações aritméticas.
Para a otimização dessa rotina computacional, o ecossistema `tidyverse` [@wickham2023r] oferece uma arquitetura orientada ao encadeamento lógico. Por meio do operador de *pipe* (`|>`), as transformações deixam de ser funções complexas e aninhadas, tornando-se fluxos de leitura linear (importação, filtro, mutação e sumarização), elevando a modularidade e a reprodutibilidade dos códigos de engenharia.
### Variáveis Tecnológicas do Concreto
A resistência à compressão desponta como a variável resposta primária no controle de qualidade. Contudo, seu desempenho é norteado por fatores de dosagem. Historicamente descrito pela *Lei de Abrams* [@abrams1918], o fator água/cimento (a/c) atua como o principal determinante da integridade mecânica da pasta de cimento endurecida; adições excessivas de água elevam a porosidade sistêmica, reduzindo a capacidade portante.
Em contrapartida, a alteração isolada do consumo de cimento, sem o balanço hídrico adequado, não assegura um incremento proporcional de resistência. Outro fator primordial consiste na evolução das reações de hidratação, processo termodinâmico contínuo que confere ganho de resistência progressivo conforme a idade do corpo de prova.
### Estatística Descritiva em Análises Agrupadas
A descrição sumária do concreto não se restringe à sua média global. O controle exige o particionamento da análise de acordo com a classe de resistência (fck) ou o lote da obra. Para isso, o coeficiente de variação (CV), obtido pela relação percentual entre o desvio padrão e a média, consolida-se como o balizador de homogeneidade da usinagem. Altos índices de CV sinalizam dispersão excessiva na produção ou nas práticas de adensamento, indicando baixa confiabilidade construtiva.
## ⚙️ Metodologia
O procedimento experimental consistiu na análise de uma base de dados estruturada em formato CSV (valores separados por vírgula), contendo 100 observações relativas ao controle de qualidade de quatro blocos distintos de uma edificação. A planilha abrange 10 variáveis, divididas entre identificadores qualitativos e grandezas físicas (compressão, consumo de aglomerante, relação a/c, abatimento, densidade e absorção).
Os dados foram processados no ambiente R, limitando-se ao uso de pacotes da família `tidyverse`. O método adotado compreendeu as seguintes etapas:
1. **Importação Preventiva:** O pacote `readr` foi utilizado para alocar a base na memória do sistema em formato de texto, blindando o arquivo contra conversões indesejadas antes do diagnóstico de formatação.
2. **Inspeção e Limpeza:** Por meio dos pacotes `dplyr` e `stringr`, instituiu-se uma cadeia de tratamento que abrangeu a supressão de espaços excedentes, padronização de nomenclatura de classe em caixa alta e a substituição de caracteres tipográficos incorretos (letras no lugar de algarismos), possibilitando a posterior conversão matemática.
3. **Exploração Multivariada:** Aplicou-se o fluxo de agrupamento (`group_by`) e sumarização (`summarise`) para extrair indicadores segmentados, preservando os espaços vazios legítimos (`NA`) para evitar o enviesamento numérico das amostras.
4. **Data Visualization:** Empregou-se o pacote `ggplot2` para traduzir as planilhas numéricas em painéis gráficos, correlacionando parâmetros de dosagem e a capacidade de suporte final dos elementos.
## 🔍 Resultados e Discussão
### Importação da base de dados
Inicialmente, a base de dados foi importada para o ambiente R. Optou-se por realizar a primeira leitura das variáveis como texto, preservando a forma original dos registros e facilitando a identificação de possíveis inconsistências de preenchimento.
```{r}
library(tidyverse)
library(knitr)

arquivo_dados <- "base_processamento_dados_engenharia_civil.csv"

dados <- read_csv2(
  arquivo_dados,
  col_types = cols(.default = col_character()),
  na = c(""," ", "NA", "N/A", "-", "null", "NULL"),
  show_col_types = FALSE
)
```
O código realiza a importação da base e armazena os dados no objeto dados. A leitura inicial como texto evita que possíveis erros de digitação sejam automaticamente convertidos ou descartados antes da etapa de diagnóstico.
### Dimensões da base de dados
Para verificar a quantidade de observações e variáveis presentes na base, foi utilizado o seguinte código:
```{r}
library(tidyverse)
library(knitr)

# Dimensões da base de dados
tabela_dimensao <- tibble(
  Informacao = c("Número de observações", "Número de variáveis"),
  Resultado = c(nrow(dados), ncol(dados))
)

# Renderização da tabela
kable(
  tabela_dimensao,
  caption = "Dimensões da base de dados"
)
```
O código contabiliza quantas linhas e colunas compõem a base, apresentando os resultados em formato de tabela.
A base apresenta 100 observações e 10 variáveis, correspondentes aos registros dos corpos de prova e às características utilizadas no estudo.
### Estrutura da base
A estrutura dos dados foi examinada por meio do seguinte código:
`glimpse(dados)`
O código proporciona uma visão geral da estrutura da base, permitindo verificar os nomes das variáveis, a quantidade de registros e o tipo inicialmente atribuído a cada coluna.
Como a importação foi propositalmente realizada em formato textual, as 10 variáveis são inicialmente apresentadas como character. Essa estratégia permite realizar a limpeza antes da conversão das variáveis quantitativas.
### Identificação de valores ausentes
A presença de valores ausentes foi investigada em todas as variáveis.
```{r}
resumo_na <- dados |>
  summarise(
    across(everything(), ~ sum(is.na(.)))
  ) |>
  pivot_longer(
    everything(),
    names_to = "variavel",
    values_to = "quantidade_na"
  ) |>
  filter(quantidade_na > 0)

kable(
  resumo_na,
  caption = "Valores ausentes identificados na base"
)
```
O código percorre a base e contabiliza os valores ausentes em cada variável, mantendo na tabela apenas aquelas em que pelo menos um NA foi identificado.
Foram identificados cinco valores ausentes, distribuídos em cinco variáveis diferentes.
Para localizar os respectivos corpos de prova:
```{r}
registros_na <- dados |>
  filter(if_any(everything(), is.na))

kable(
  registros_na,
  caption = "Registros contendo valores ausentes"
)
```
Esse código seleciona os registros completos que apresentam pelo menos um valor ausente, permitindo identificar onde cada ocorrência está localizada.
Portanto, os valores ausentes estão distribuídos em cinco observações distintas da base.
### Verificação da variável `obra`
A padronização das categorias da variável obra foi verificada antes de qualquer tratamento.
```{r}
tabela_obra <- dados |>
  count(obra, name = "frequencia")

kable(
  tabela_obra,
  caption = "Categorias originais da variável obra"
)
```
O código identifica todas as formas de escrita encontradas para a variável obra e contabiliza suas respectivas frequências.
Foi identificada uma inconsistência na variável obra. Um dos registros contém Bloco B com um espaço adicional ao final do texto.
Embora visualmente seja semelhante a Bloco B, para o R essas duas formas podem ser interpretadas como categorias diferentes. Após a remoção do espaço, o Bloco B passa a apresentar 29 registros.
### Verificação da variável tipo_concreto
A mesma análise foi realizada para a classificação do concreto.
```{r}
tabela_tipo <- dados |>
  count(tipo_concreto, name = "frequencia")

kable(
  tabela_tipo,
  caption = "Categorias originais de tipo de concreto"
)
```
O código verifica quais categorias de concreto estão presentes na base e quantas vezes cada uma aparece.
Foi encontrada a categoria c30, que representa o mesmo tipo de concreto que C30, diferenciando-se apenas pelo emprego de letras minúsculas.
Após a padronização, a categoria C30 passa a possuir 32 observações.
### Identificação de possíveis erros de digitação
Como os dados foram inicialmente importados como texto, foi possível procurar caracteres incompatíveis com a representação numérica esperada.
```{r}
problemas_texto <- dados |>
  pivot_longer(
    cols = c(
      resistencia_mpa,
      cimento_kg_m3,
      relacao_a_c,
      abatimento_mm,
      densidade_kg_m3,
      `absorção_agregado_pct`
    ),
    names_to = "variavel",
    values_to = "valor_original"
  ) |>
  filter(str_detect(valor_original, "[Oo,]"))

kable(
  problemas_texto,
  caption = "Possíveis inconsistências de digitação"
)
```
O código procura valores numéricos que apresentam vírgulas ou a letra O, permitindo localizar registros que necessitam de padronização antes da conversão numérica.
Os registros CP-019 e CP-064 apresentam fortes indícios de erro de digitação, enquanto CP-008 e CP-045 apresentam inconsistência no separador decimal utilizado.
### Limpeza e padronização da base
Após o diagnóstico inicial, foi criada uma função para realizar a conversão das variáveis quantitativas.
```{r}
converter_numero <- function(x) {
  x |>
    str_trim() |>
    str_replace_all("[Oo]", "0") |>
    str_replace_all(",", ".") |>
    parse_double(
      locale = locale(decimal_mark = "."),
      na = c("", "NA", "N/A", "-", "null", "NULL")
    )
}
```
Esse código estabelece um procedimento único de padronização dos valores numéricos, corrigindo caracteres incompatíveis e preparando os dados para conversão.
Em seguida, foi criada a base tratada:
```{r}
dados_limpos <- dados |>
  rename(
    absorcao_agregado_pct = `absorção_agregado_pct`
  ) |>
  mutate(
    id_corpo_prova = str_trim(id_corpo_prova),
    obra = str_trim(obra),
    tipo_concreto = str_to_upper(str_trim(tipo_concreto)),
    idade_dias = parse_integer(str_trim(idade_dias)),
    across(
      c(
        resistencia_mpa,
        cimento_kg_m3,
        relacao_a_c,
        abatimento_mm,
        densidade_kg_m3,
        absorcao_agregado_pct
      ),
      converter_numero
    )
  )
```
O código realiza a limpeza geral da base, removendo espaços desnecessários, padronizando as categorias e convertendo as variáveis quantitativas para formato numérico.
Após essa etapa, Bloco b passa a ser Bloco B e c30 passa a ser C30.
### Verificação das categorias após a limpeza
```{r}
dados_limpos |>
  count(obra) |>
  kable(
    caption = "Distribuição das obras após a padronização"
  )
```
O código verifica o resultado da padronização da variável obra, permitindo confirmar que categorias equivalentes foram agrupadas corretamente.
A limpeza eliminou a categoria adicional causada pelo espaço existente em Bloco B.
```{r}
dados_limpos |>
  count(tipo_concreto) |>
  kable( caption = "Distribuição dos tipos de concreto após a padronização" )
```
Esse código confirma a padronização final das classes de concreto.
Após a limpeza, permanecem apenas as quatro classes de concreto esperadas.
### Valores potencialmente incompatíveis com o contexto da Engenharia Civil
Para identificar observações que merecem investigação, foram estabelecidos critérios de triagem.
```{r}
registros_suspeitos <- dados_limpos |>
  filter(
    abatimento_mm > 300 |
    densidade_kg_m3 < 1000 |
    absorcao_agregado_pct > 4 |
    idade_dias > 100
  )

kable(
  registros_suspeitos,
  caption = "Registros potencialmente incompatíveis"
)
```
O código seleciona valores que se afastam consideravelmente do comportamento esperado das variáveis, funcionando como uma etapa de triagem para posterior conferência.
Destacam-se o abatimento de 1250 mm no CP-032, a densidade de 238 kg/m³ no CP-053 e a absorção de 18,40% no CP-072. O CP-085 apresenta idade de 280 dias, valor atípico em relação às demais idades da base.
Esses valores devem ser considerados suspeitos, e não necessariamente incorretos, sendo recomendável conferir os registros originais dos ensaios antes de qualquer alteração.
### Tratamento dos valores ausentes
Os valores ausentes foram mantidos na base tratada, evitando substituições arbitrárias.
```{r}
dados_limpos |>
  summarise(
    across(everything(), ~ sum(is.na(.)))
  ) |>
  pivot_longer(
    everything(),
    names_to = "variavel",
    values_to = "quantidade"
  ) |>
  filter(quantidade > 0) |>
  kable(
    caption = "Valores ausentes após a limpeza"
  )
```
O código verifica se os valores ausentes originais foram preservados após a conversão e limpeza dos dados.
Optou-se por não realizar imputação, pois a substituição desses valores poderia introduzir informações artificiais e interferir nos resultados estatísticos.
### Estatística descritiva da resistência
```{r}
resumo_resistencia <- dados_limpos |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    Media = mean(resistencia_mpa, na.rm = TRUE),
    Mediana = median(resistencia_mpa, na.rm = TRUE),
    DP = sd(resistencia_mpa, na.rm = TRUE),
    CV = 100 * DP / Media,
    Minimo = min(resistencia_mpa, na.rm = TRUE),
    Q1 = quantile(resistencia_mpa, 0.25, na.rm = TRUE),
    Q3 = quantile(resistencia_mpa, 0.75, na.rm = TRUE),
    Maximo = max(resistencia_mpa, na.rm = TRUE)
  )

kable(
  resumo_resistencia,
  digits = 2,
  caption = "Estatística descritiva da resistência à compressão"
)
```
O código calcula os principais indicadores de posição e dispersão da resistência à compressão, proporcionando uma caracterização geral do comportamento da variável.
A resistência média foi de 33,55 MPa, enquanto a mediana foi de 32,30 MPa. O coeficiente de variação foi de aproximadamente 19,47%, indicando a dispersão dos resultados em relação à média.
### Resistência por obra
```{r}
resumo_obra <- dados_limpos |>
  group_by(obra) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    Media = mean(resistencia_mpa, na.rm = TRUE),
    Mediana = median(resistencia_mpa, na.rm = TRUE),
    DP = sd(resistencia_mpa, na.rm = TRUE),
    CV = 100 * DP / Media
  ) |>
  arrange(desc(Media))

kable(
  resumo_obra,
  digits = 2,
  caption = "Resistência à compressão por obra"
)
```
O código compara a resistência à compressão entre as quatro obras, considerando medidas de tendência central e variabilidade.
O Bloco B apresentou a maior resistência média, enquanto o Bloco C apresentou a menor média entre os grupos. O Bloco D apresentou o maior coeficiente de variação, indicando maior dispersão relativa.
### Resistência por tipo de concreto
```{r}
resumo_tipo <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    Media = mean(resistencia_mpa, na.rm = TRUE),
    Mediana = median(resistencia_mpa, na.rm = TRUE),
    DP = sd(resistencia_mpa, na.rm = TRUE),
    CV = 100 * DP / Media,
    Minimo = min(resistencia_mpa, na.rm = TRUE),
    Maximo = max(resistencia_mpa, na.rm = TRUE)
  )

kable(
  resumo_tipo,
  digits = 2,
  caption = "Resistência segundo o tipo de concreto"
)
```
O código permite comparar o comportamento da resistência entre as diferentes classes de concreto.
Observa-se uma progressão das médias de resistência entre C25 e C40. O concreto C40 apresentou a maior média e o menor coeficiente de variação.
### Resistência em função da idade
```{r}
resumo_idade <- dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    Media = mean(resistencia_mpa, na.rm = TRUE),
    DP = sd(resistencia_mpa, na.rm = TRUE)
  )

kable(
  resumo_idade,
  digits = 2,
  caption = "Resistência segundo a idade dos corpos de prova"
)
```
O código agrupa os corpos de prova segundo sua idade de ensaio, permitindo comparar a resistência média observada em cada período.
A interpretação deve considerar que os grupos possuem diferentes classes de concreto e tamanhos amostrais, não sendo adequado atribuir as diferenças observadas exclusivamente à idade.
### Criação de indicadores de desempenho
```{r}
dados_limpos <- dados_limpos |>
  mutate(
    fck_referencia = case_when(
      tipo_concreto == "C25" ~ 25,
      tipo_concreto == "C30" ~ 30,
      tipo_concreto == "C35" ~ 35,
      tipo_concreto == "C40" ~ 40
    ),
    resistencia_relativa =
      resistencia_mpa / fck_referencia,

    classificacao = case_when(
      resistencia_relativa >= 1.10 ~ "Excelente",
      resistencia_relativa >= 0.95 ~ "Bom",
      resistencia_relativa >= 0.85 ~ "Regular",
      !is.na(resistencia_relativa) ~ "Insatisfatório",
      TRUE ~ "Ausente"
    )
  )
```
O código cria indicadores derivados para comparar a resistência observada com o valor de referência associado à classe do concreto.
```{r}
dados_limpos |>
  count(classificacao) |>
  mutate(
    Percentual = 100 * n / sum(n)
  ) |>
  kable(
    digits = 1,
    caption = "Classificação dos resultados de resistência"
  )
```
O código resume a distribuição das classificações obtidas, apresentando a quantidade e o percentual correspondente a cada categoria.
Considerando toda a base, 86% dos registros foram classificados como Bom ou Excelente segundo o critério descritivo adotado.
### Relação entre resistência e demais variáveis
```{r}
correlacoes <- tibble(
  Relacao = c(
    "Cimento × Resistência",
    "Relação a/c × Resistência"
  ),
  Correlacao = c(
    cor(
      dados_limpos$cimento_kg_m3,
      dados_limpos$resistencia_mpa,
      use = "complete.obs"
    ),
    cor(
      dados_limpos$relacao_a_c,
      dados_limpos$resistencia_mpa,
      use = "complete.obs"
    )
  )
)

kable(
  correlacoes,
  digits = 3,
  caption = "Correlações com a resistência à compressão"
)
```
O código avalia a intensidade e o sentido da associação linear entre a resistência e duas variáveis relacionadas à composição do concreto.
A quantidade de cimento apresentou correlação linear praticamente nula com a resistência quando toda a base é considerada conjuntamente. Já a relação água/cimento apresentou correlação negativa relativamente forte, indicando que valores maiores de relação a/c estão associados a menores valores de resistência nesta amostra.
Essa associação deve ser interpretada como uma característica dos dados analisados, não sendo suficiente, isoladamente, para estabelecer relação de causa e efeito.
### Síntese dos principais resultados
A partir das análises realizadas, os principais resultados podem ser consolidados em uma tabela final.
```{r}
resumo_final <- tibble(
  Indicador = c(
    "Observações",
    "Variáveis originais",
    "Valores ausentes originais",
    "Resistência média",
    "Mediana da resistência",
    "CV da resistência",
    "Obra com maior média",
    "Classe com maior média",
    "Correlação a/c × resistência",
    "Bom ou Excelente"
  ),
  Resultado = c(
    "100",
    "10",
    "5",
    "33,55 MPa",
    "32,30 MPa",
    "19,47%",
    "Bloco B - 35,70 MPa",
    "C40 - 43,33 MPa",
    "-0,764",
    "86%"
  )
)

kable(
  resumo_final,
  caption = "Síntese dos principais resultados"
)
```
O código reúne os indicadores mais relevantes obtidos ao longo da análise, permitindo uma leitura rápida dos resultados do processamento.
Os resultados demonstram que a etapa de tratamento foi necessária para corrigir problemas de padronização textual, representação numérica e categorização. A manutenção de uma base original e a criação de uma base tratada permitiram preservar a rastreabilidade das modificações realizadas.
### Verificação final
```{r}
glimpse(dados_limpos)
tibble(
  Observacoes = nrow(dados_limpos),
  Variaveis = ncol(dados_limpos),
  Obras = n_distinct(dados_limpos$obra),
  Tipos_concreto = n_distinct(dados_limpos$tipo_concreto),
  Valores_ausentes = sum(is.na(dados_limpos))
) |>
  kable(
    caption = "Verificação final da base tratada"
  )
```
O código realiza uma última conferência da estrutura da base, verificando suas dimensões, categorias e valores ausentes após o tratamento.
É importante diferenciar os valores ausentes da base original daqueles contabilizados após a criação de variáveis derivadas. A base original possui cinco células ausentes. Caso novas variáveis sejam calculadas a partir de uma informação ausente, o NA pode ser propagado para essas novas colunas, aumentando a contagem total de células NA sem representar novos erros nos dados originais.
### Representações Gráficas
Nesta etapa, foram utilizadas ferramentas do pacote `ggplot2` para representar graficamente algumas das principais relações presentes na base de dados. Os gráficos complementam as análises numéricas e auxiliam na identificação de diferenças entre grupos, tendências e possíveis associações entre as variáveis estudadas.
#### Distribuição da resistência à compressão por tipo de concreto
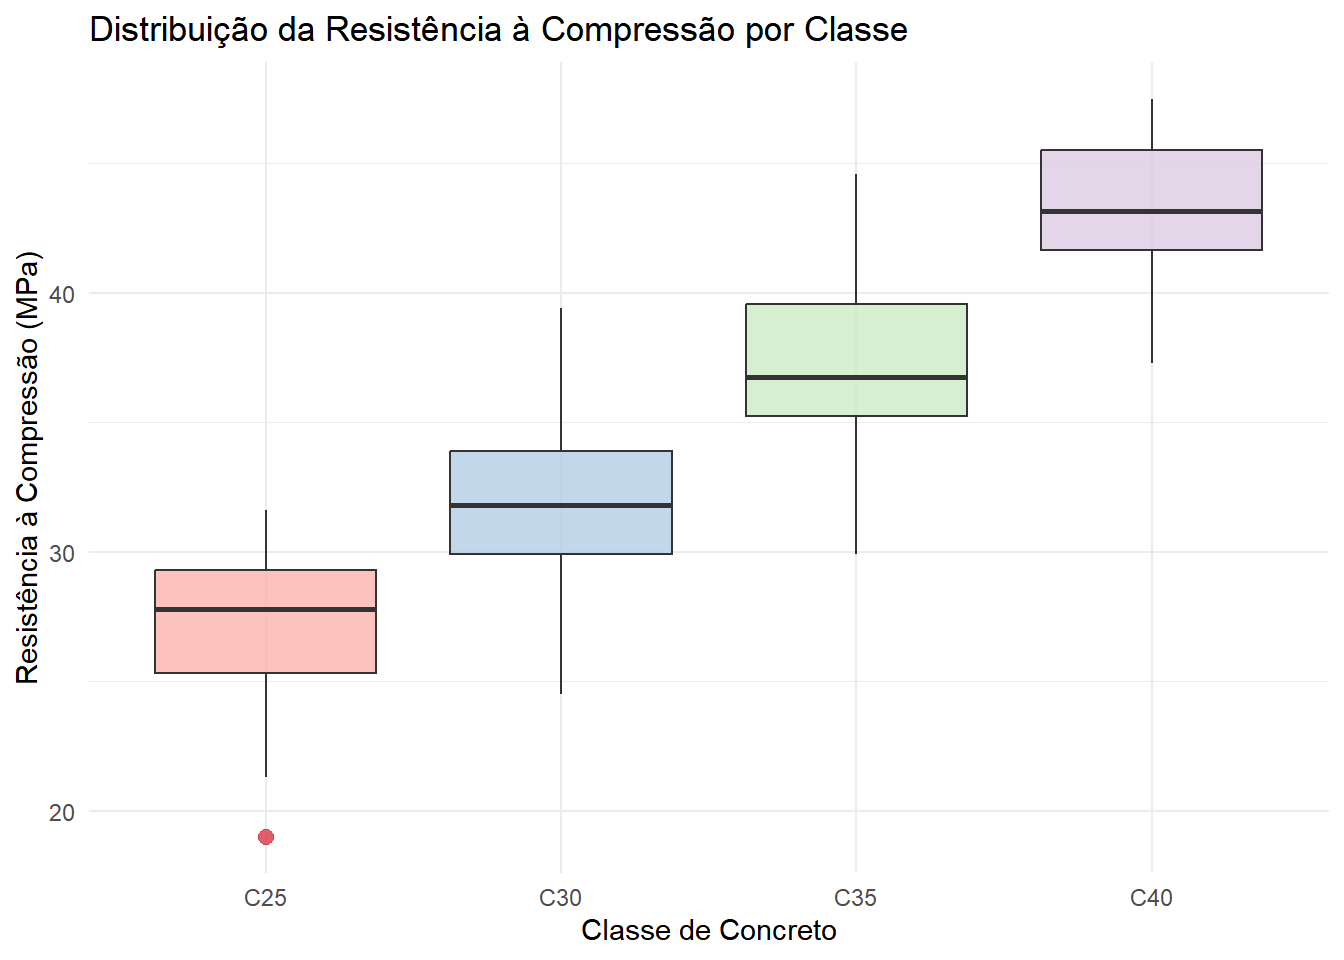
Para comparar a distribuição da resistência à compressão entre os diferentes tipos de concreto, utilizou-se um diagrama de caixas (*boxplot*).
```{r}
#| label: boxplot-resistencias
#| echo: true
#| fig-align: "center"
ggplot(
  dados_limpos,
  aes(
    x = tipo_concreto,
    y = resistencia_mpa,
    fill = tipo_concreto
  )
) +
  geom_boxplot(alpha = 0.8, outlier.color = "#DC3545", outlier.size = 2.5) +
  scale_fill_brewer(palette = "Pastel1") +
  labs(
    title = "Distribuição da Resistência à Compressão por Classe",
    x = "Classe de Concreto",
    y = "Resistência à Compressão (MPa)"
  ) +
  theme_minimal() +
  theme(legend.position = "none")
```
O gráfico evidencia uma progressão consolidada da resistência à compressão conforme o aumento da classe de projeto do material. De maneira geral, os valores observados para os traços C25 são inferiores e apresentam limites mais estreitos quando comparados aos resultados de alto desempenho das classes C35 e C40.
#### Consumo de cimento e resistência à compressão
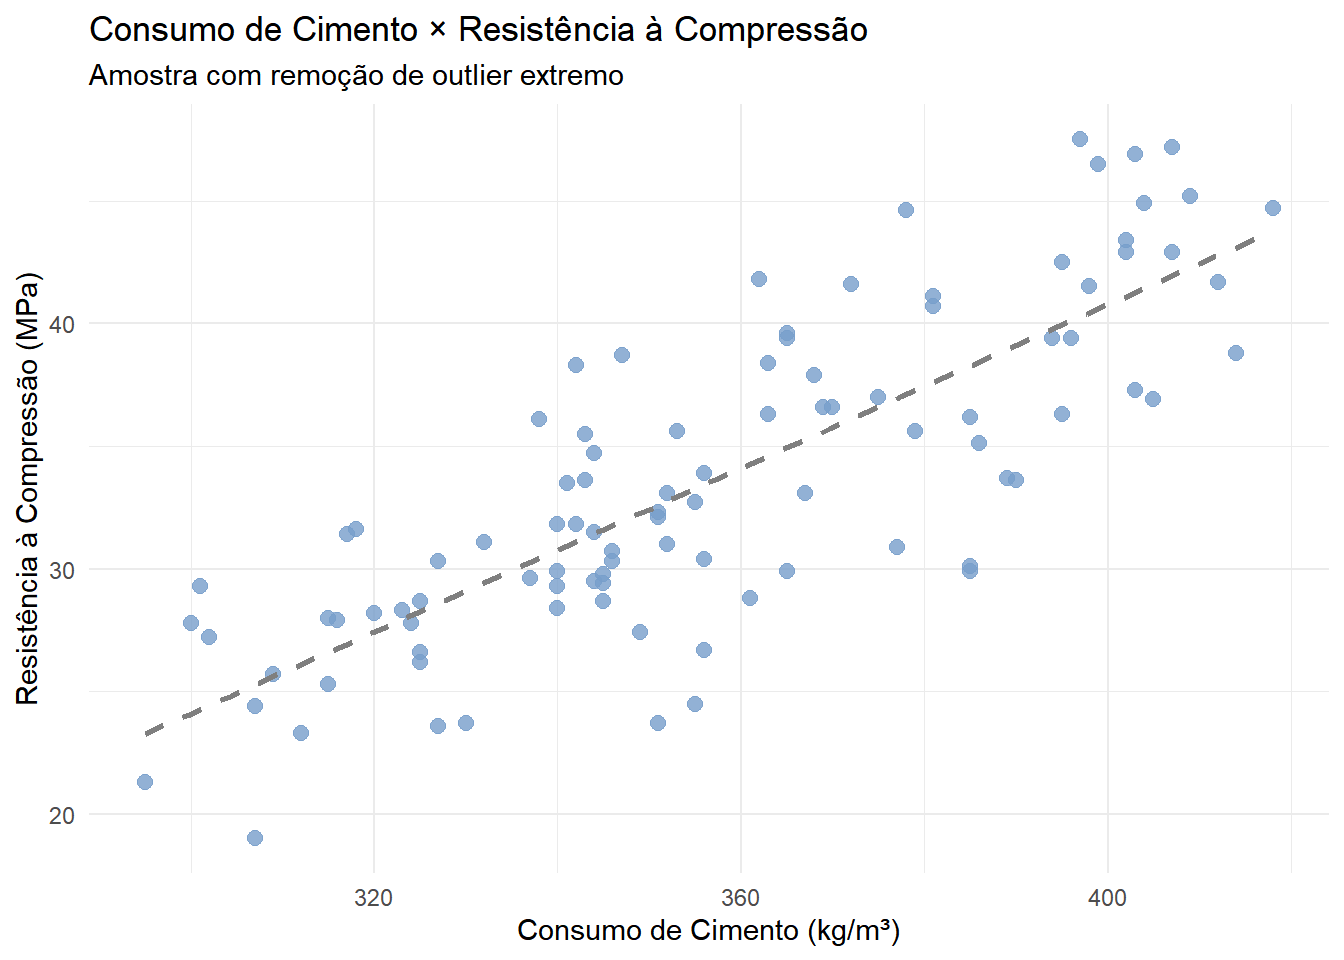
Para investigar a relação entre o consumo de aglomerante e a resistência à compressão, elaborou-se um diagrama de dispersão. Visando evitar vieses analíticos, procedeu-se com a remoção prévia de um *outlier* severo oriundo de erro de digitação (registro na ordem de 3.900 kg/m³), o qual distorcia o modelo de regressão linear.
```{r}
#| label: cimento-resistencia
#| echo: true
#| fig-align: "center"
# Filtro preventivo para remoção de anomalia de digitação
dados_cimento <- dados_limpos |>
  filter(cimento_kg_m3 < 1000)

ggplot(
  dados_cimento,
  aes(
    x = cimento_kg_m3,
    y = resistencia_mpa
  )
) +
  geom_point(
    color = "#779ECB",
    alpha = 0.8,
    size = 2.5
  ) +
  geom_smooth(
    method = "lm",
    se = FALSE,
    color = "gray50",
    linetype = "dashed"
  ) +
  labs(
    title = "Consumo de Cimento × Resistência à Compressão",
    subtitle = "Amostra com remoção de outlier extremo",
    x = "Consumo de Cimento (kg/m³)",
    y = "Resistência à Compressão (MPa)"
  ) +
  theme_minimal()
```
Para complementar a interpretação visual da linha de tendência, obteve-se o coeficiente de correlação entre as duas variáveis a partir da base higienizada:
```{r}
#| label: cor-cimento
#| echo: true
cor(
  dados_cimento$cimento_kg_m3,
  dados_cimento$resistencia_mpa,
  use = "complete.obs"
)
```
O coeficiente de correlação de Pearson presenta um valor na ordem de 0,80. Este índice revela uma **associação linear positiva forte** entre o consumo de cimento e a resistência do material. O gráfico consolida esse resultado ao exibir a nuvem de pontos agrupada em torno de uma nítida linha de tendência crescente.
Dessa forma, os dados analisados dão suporte à afirmação de que o aumento do consumo de cimento eleva a resistência do concreto. No contexto tecnológico, tal comportamento é plenamente coerente: o desenvolvimento de concretos de alto desempenho (como a classe C40 da amostra) exige maiores teores de aglomerante que, operando em conjunto com reduções na relação água/cimento, impulsionam o ganho de resistência mecânica.
#### Relação água/cimento e resistência à compressão
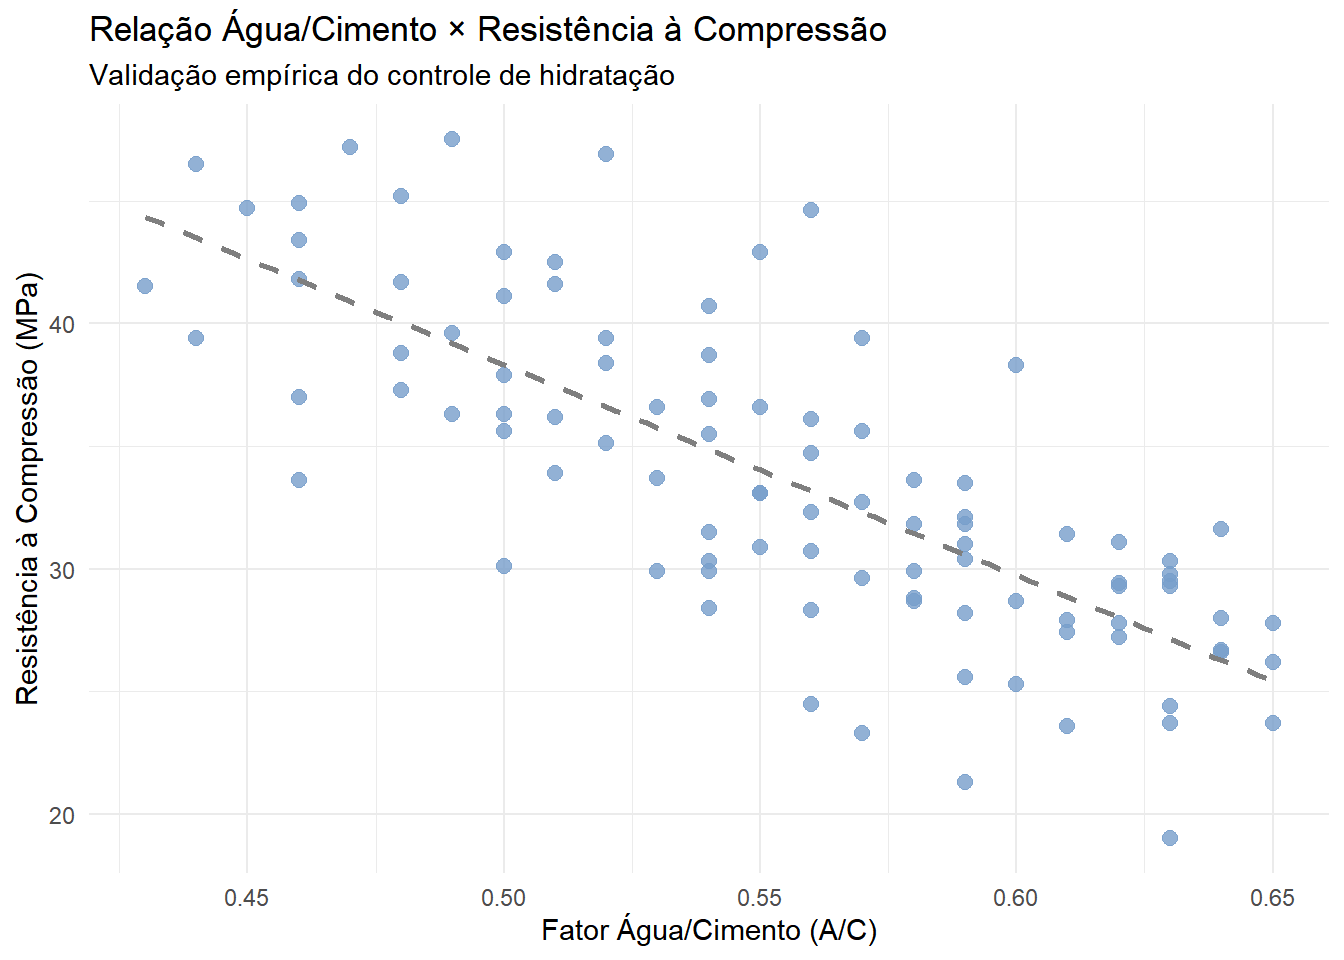
A influência do volume hídrico no desempenho estrutural foi avaliada por meio de um segundo diagrama de dispersão.
```{r}
#| label: ac-resistencia
#| echo: true
#| fig-align: "center"
ggplot(
  dados_limpos,
  aes(
    x = relacao_a_c,
    y = resistencia_mpa
  )
) +
  geom_point(
    color = "#779ECB",
    alpha = 0.8,
    size = 2.5
  ) +
  geom_smooth(
    method = "lm",
    se = FALSE,
    color = "gray50",
    linetype = "dashed"
  ) +
  labs(
    title = "Relação Água/Cimento × Resistência à Compressão",
    subtitle = "Validação empírica do controle de hidratação",
    x = "Fator Água/Cimento (A/C)",
    y = "Resistência à Compressão (MPa)"
  ) +
  theme_minimal()
```
A intensidade métrica dessa associação foi ratificada pelo cálculo de correlação:
```{r}
#| label: cor-ac
#| echo: true
cor(
  dados_limpos$relacao_a_c,
  dados_limpos$resistencia_mpa,
  use = "complete.obs"
)
```
O gráfico revela uma inclinação decrescente acentuada: à medida que a relação água/cimento é elevada, a resistência à compressão sofre uma queda drástica. O coeficiente de correlação de Pearson (-0,764) atesta uma associação linear negativa forte, validando empiricamente o comportamento teórico fundamentado pela Engenharia. Constata-se que o rigor no limite de água da mistura é o vetor principal para a obtenção de concretos de alta performance.
### Desafio ao Engenheiro
Script consolidado
```r
# ============================================================
# DESAFIO FINAL - O ENGENHEIRO RESPONSÁVEL PELOS DADOS
# Análise, diagnóstico, limpeza e exploração da base
# ============================================================
#| eval: false
#| echo: true
library(tidyverse)
library(knitr)

# ------------------------------------------------------------
# 1. IMPORTAÇÃO DA BASE
# ------------------------------------------------------------

arquivo_dados <- "base_processamento_dados_engenharia_civil.csv"

dados <- read_csv2(
  arquivo_dados,
  col_types = cols(.default = col_character()),
  na = c("", " ", "NA", "N/A", "-", "null", "NULL"),
  show_col_types = FALSE
)

# ------------------------------------------------------------
# 2. INSPEÇÃO INICIAL
# ------------------------------------------------------------

glimpse(dados)

dimensoes <- dados |>
  summarise(
    observacoes = n(),
    variaveis = ncol(dados)
  )

kable(dimensoes, caption = "Dimensões da base de dados")

dados |>
  slice_head(n = 6) |>
  kable(caption = "Primeiros registros da base")

# ------------------------------------------------------------
# 3. VERIFICAÇÃO DE VALORES AUSENTES
# ------------------------------------------------------------

resumo_na <- dados |>
  summarise(across(everything(), ~ sum(is.na(.)))) |>
  pivot_longer(
    cols = everything(),
    names_to = "variavel",
    values_to = "quantidade_na"
  ) |>
  filter(quantidade_na > 0)

kable(resumo_na, caption = "Valores ausentes identificados na base")

registros_na <- dados |>
  filter(if_any(everything(), is.na))

kable(registros_na, caption = "Registros contendo valores ausentes")

# ------------------------------------------------------------
# 4. VERIFICAÇÃO DAS VARIÁVEIS CATEGÓRICAS
# ------------------------------------------------------------

dados |>
  count(obra, sort = TRUE) |>
  kable(caption = "Categorias originais da variável obra")

dados |> distinct(obra) |> arrange(obra)

dados |>
  count(tipo_concreto, sort = TRUE) |>
  kable(caption = "Categorias originais da variável tipo_concreto")

dados |> distinct(tipo_concreto) |> arrange(tipo_concreto)

# ------------------------------------------------------------
# 5. IDENTIFICAÇÃO DE POSSÍVEIS ERROS DE DIGITAÇÃO
# ------------------------------------------------------------

problemas_numericos <- dados |>
  pivot_longer(
    cols = c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, `absorção_agregado_pct`),
    names_to = "variavel",
    values_to = "valor_original"
  ) |>
  filter(str_detect(valor_original, "[Oo,]")) |>
  select(id_corpo_prova, variavel, valor_original)

kable(problemas_numericos, caption = "Possíveis problemas de digitação")

# ------------------------------------------------------------
# 6. FUNÇÃO PARA CONVERSÃO DOS VALORES NUMÉRICOS
# ------------------------------------------------------------

converter_numero <- function(x) {
  x |>
    str_trim() |>
    str_replace_all("[Oo]", "0") |>
    str_replace_all(",", ".") |>
    parse_double(
      locale = locale(decimal_mark = "."),
      na = c("", "NA", "N/A", "-", "null", "NULL")
    )
}

# ------------------------------------------------------------
# 7. LIMPEZA E PADRONIZAÇÃO DA BASE
# ------------------------------------------------------------

dados_limpos <- dados |>
  rename(absorcao_agregado_pct = `absorção_agregado_pct`) |>
  mutate(
    id_corpo_prova = str_trim(id_corpo_prova),
    obra = str_trim(obra),
    tipo_concreto = str_to_upper(str_trim(tipo_concreto)),
    idade_dias = parse_integer(str_trim(idade_dias)),
    across(
      c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorcao_agregado_pct),
      converter_numero
    )
  )

# ------------------------------------------------------------
# 8. CONFERÊNCIA APÓS A LIMPEZA
# ------------------------------------------------------------

dados_limpos |> count(obra) |> kable(caption = "Distribuição das obras após a limpeza")
dados_limpos |> count(tipo_concreto) |> kable(caption = "Distribuição dos tipos de concreto após a limpeza")
glimpse(dados_limpos)

# ------------------------------------------------------------
# 9. IDENTIFICAÇÃO DE VALORES POTENCIALMENTE SUSPEITOS
# ------------------------------------------------------------

valores_suspeitos <- dados_limpos |>
  filter(
    abatimento_mm > 300 |
    densidade_kg_m3 < 1000 |
    absorcao_agregado_pct > 4 |
    idade_dias > 100
  )

kable(valores_suspeitos, digits = 2, caption = "Registros potencialmente incompatíveis")

# ------------------------------------------------------------
# 10. ESTATÍSTICAS DESCRITIVAS GERAIS
# ------------------------------------------------------------

resumo_resistencia <- dados_limpos |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media = mean(resistencia_mpa, na.rm = TRUE),
    mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    coef_variacao = 100 * desvio_padrao / media,
    minimo = min(resistencia_mpa, na.rm = TRUE),
    q1 = quantile(resistencia_mpa, 0.25, na.rm = TRUE),
    q3 = quantile(resistencia_mpa, 0.75, na.rm = TRUE),
    maximo = max(resistencia_mpa, na.rm = TRUE)
  )

kable(resumo_resistencia, digits = 2, caption = "Resumo estatístico da resistência à compressão")

# ------------------------------------------------------------
# 11. ESTATÍSTICAS POR TIPO DE CONCRETO
# ------------------------------------------------------------

resumo_tipo <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media = mean(resistencia_mpa, na.rm = TRUE),
    mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    coef_variacao = 100 * desvio_padrao / media,
    minimo = min(resistencia_mpa, na.rm = TRUE),
    maximo = max(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(tipo_concreto)

kable(resumo_tipo, digits = 2, caption = "Resistência por tipo de concreto")

# ------------------------------------------------------------
# 12. ESTATÍSTICAS POR OBRA
# ------------------------------------------------------------

resumo_obra <- dados_limpos |>
  group_by(obra) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media = mean(resistencia_mpa, na.rm = TRUE),
    mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    coef_variacao = 100 * desvio_padrao / media,
    .groups = "drop"
  ) |>
  arrange(desc(media))

kable(resumo_obra, digits = 2, caption = "Resistência à compressão por obra")

# ------------------------------------------------------------
# 13. ESTATÍSTICAS POR IDADE
# ------------------------------------------------------------

resumo_idade <- dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(idade_dias)

kable(resumo_idade, digits = 2, caption = "Resistência média em função da idade")

# ------------------------------------------------------------
# 14. CRIAÇÃO DE VARIÁVEIS DERIVADAS
# ------------------------------------------------------------

dados_limpos <- dados_limpos |>
  mutate(
    fck_referencia = case_when(
      tipo_concreto == "C25" ~ 25,
      tipo_concreto == "C30" ~ 30,
      tipo_concreto == "C35" ~ 35,
      tipo_concreto == "C40" ~ 40,
      TRUE ~ NA_real_
    ),
    resistencia_relativa = resistencia_mpa / fck_referencia,
    classificacao = case_when(
      is.na(resistencia_relativa) ~ "Ausente",
      resistencia_relativa >= 1.10 ~ "Excelente",
      resistencia_relativa >= 0.95 ~ "Bom",
      resistencia_relativa >= 0.85 ~ "Regular",
      TRUE ~ "Insatisfatório"
    )
  ) |>
  group_by(tipo_concreto) |>
  mutate(
    media_classe = mean(resistencia_mpa, na.rm = TRUE),
    acima_media_classe = if_else(
      resistencia_mpa > media_classe,
      "Acima da média",
      "Na média ou abaixo",
      missing = "Resistência ausente"
    )
  ) |>
  ungroup()

# ------------------------------------------------------------
# 15. RESUMO DAS CLASSIFICAÇÕES
# ------------------------------------------------------------

resumo_classificacao <- dados_limpos |>
  count(classificacao) |>
  mutate(percentual = 100 * n / sum(n)) |>
  arrange(desc(n))

kable(resumo_classificacao, digits = 1, caption = "Classificação descritiva dos resultados")

# ------------------------------------------------------------
# 16. CORRELAÇÕES
# ------------------------------------------------------------

# Filtro do outlier do cimento para a correlação e gráfico corretos
dados_cimento <- dados_limpos |>
  filter(cimento_kg_m3 < 1000)

correlacoes <- tibble(
  Relacao = c("Cimento × Resistência (Sem outlier)", "Relação a/c × Resistência"),
  Correlacao_Pearson = c(
    cor(dados_cimento$cimento_kg_m3, dados_cimento$resistencia_mpa, use = "complete.obs"),
    cor(dados_limpos$relacao_a_c, dados_limpos$resistencia_mpa, use = "complete.obs")
  )
)

kable(correlacoes, digits = 3, caption = "Correlações com a resistência à compressão")

# ------------------------------------------------------------
# 17. GRÁFICO 1 - RESISTÊNCIA POR TIPO DE CONCRETO
# ------------------------------------------------------------

ggplot(dados_limpos, aes(x = tipo_concreto, y = resistencia_mpa, fill = tipo_concreto)) +
  geom_boxplot(alpha = 0.8, outlier.color = "#DC3545", outlier.size = 2.5) +
  scale_fill_brewer(palette = "Pastel1") +
  labs(
    title = "Distribuição da Resistência à Compressão por Tipo de Concreto",
    x = "Tipo de concreto",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal() +
  theme(legend.position = "none")

# ------------------------------------------------------------
# 18. GRÁFICO 2 - CIMENTO × RESISTÊNCIA
# ------------------------------------------------------------

ggplot(dados_cimento, aes(x = cimento_kg_m3, y = resistencia_mpa)) +
  geom_point(color = "#779ECB", alpha = 0.8, size = 2.5) +
  geom_smooth(method = "lm", se = FALSE, color = "gray50", linetype = "dashed") +
  labs(
    title = "Consumo de Cimento × Resistência à Compressão",
    subtitle = "Amostra com remoção de outlier extremo",
    x = "Consumo de cimento (kg/m³)",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()

# ------------------------------------------------------------
# 19. GRÁFICO 3 - RELAÇÃO A/C × RESISTÊNCIA
# ------------------------------------------------------------

ggplot(dados_limpos, aes(x = relacao_a_c, y = resistencia_mpa)) +
  geom_point(color = "#779ECB", alpha = 0.8, size = 2.5) +
  geom_smooth(method = "lm", se = FALSE, color = "gray50", linetype = "dashed") +
  labs(
    title = "Relação Água/Cimento × Resistência à Compressão",
    x = "Relação água/cimento",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()

# ------------------------------------------------------------
# 20. GRÁFICO 4 - COMPARAÇÃO ENTRE OBRAS
# ------------------------------------------------------------

ggplot(dados_limpos, aes(x = obra, y = resistencia_mpa, fill = obra)) +
  geom_boxplot(alpha = 0.8) +
  scale_fill_brewer(palette = "Pastel2") +
  labs(
    title = "Distribuição da Resistência à Compressão por Obra",
    x = "Obra",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal() +
  theme(legend.position = "none")

# ------------------------------------------------------------
# 21. GRÁFICO 5 - RESISTÊNCIA MÉDIA POR IDADE
# ------------------------------------------------------------

ggplot(resumo_idade, aes(x = idade_dias, y = resistencia_media)) +
  geom_point(color = "#E74C3C", size = 3) +
  geom_line(color = "#E74C3C", size = 1) +
  labs(
    title = "Resistência Média à Compressão × Idade",
    x = "Idade do corpo de prova (dias)",
    y = "Resistência média (MPa)"
  ) +
  theme_minimal()

# ------------------------------------------------------------
# 22. GRÁFICO 6 - HISTOGRAMA DA RESISTÊNCIA
# ------------------------------------------------------------

ggplot(dados_limpos, aes(x = resistencia_mpa)) +
  geom_histogram(bins = 15, fill = "#779ECB", color = "white") +
  labs(
    title = "Distribuição Geral da Resistência à Compressão",
    x = "Resistência à compressão (MPa)",
    y = "Frequência"
  ) +
  theme_minimal()

# ------------------------------------------------------------
# 23. RESUMO PARA O ENGENHEIRO (PAINEL EXECUTIVO)
# ------------------------------------------------------------

resumo_engenheiro <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    Amostras_Validas = sum(!is.na(resistencia_mpa)),
    Resistencia_Media = mean(resistencia_mpa, na.rm = TRUE),
    Fator_AC_Medio = mean(relacao_a_c, na.rm = TRUE),
    Consumo_Cimento_Medio = mean(cimento_kg_m3, na.rm = TRUE),
    CV_Resistencia_pct = (sd(resistencia_mpa, na.rm = TRUE) / Resistencia_Media) * 100,
    Taxa_Aprovacao_pct = (sum(classificacao %in% c("Excelente", "Bom"), na.rm = TRUE) / sum(!is.na(classificacao))) * 100
  ) |>
  mutate(across(where(is.numeric), ~ round(., 2)))

kable(resumo_engenheiro, align = "c", caption = "Painel Executivo: Indicadores Estratégicos por Classe")

# ------------------------------------------------------------
# 24. REGISTROS PRIORITÁRIOS PARA CONFERÊNCIA
# ------------------------------------------------------------

registros_prioritarios <- dados_limpos |>
  mutate(
    motivo_verificacao = case_when(
      abatimento_mm > 300 ~ "Abatimento suspeito",
      densidade_kg_m3 < 1000 ~ "Densidade suspeita",
      absorcao_agregado_pct > 4 ~ "Absorção suspeita",
      idade_dias > 100 ~ "Idade atípica",
      is.na(resistencia_mpa) ~ "Resistência ausente",
      resistencia_mpa < fck_referencia ~ "Resistência abaixo da referência",
      TRUE ~ "Sem prioridade"
    )
  ) |>
  filter(motivo_verificacao != "Sem prioridade") |>
  select(
    id_corpo_prova, obra, tipo_concreto, idade_dias,
    resistencia_mpa, fck_referencia, motivo_verificacao
  ) |>
  arrange(motivo_verificacao, resistencia_mpa)

kable(registros_prioritarios, digits = 2, caption = "Registros prioritários para conferência e auditoria")

# ------------------------------------------------------------
# 25. VERIFICAÇÃO FINAL
# ------------------------------------------------------------

glimpse(dados_limpos)

verificacao_final <- dados_limpos |>
  summarise(
    observacoes = n(),
    variaveis = ncol(dados_limpos),
    obras = n_distinct(obra),
    tipos_concreto = n_distinct(tipo_concreto),
    resistencia_ausente = sum(is.na(resistencia_mpa))
  )

kable(verificacao_final, caption = "Verificação estrutural final da base tratada")
```
## 🧠 Considerações finais
A prática teve como objetivo aplicar ferramentas de processamento, limpeza e análise exploratória de dados utilizando o tidyverse, considerando uma base relacionada ao controle tecnológico do concreto. O objetivo foi alcançado, pois foi possível identificar inconsistências, padronizar os dados, produzir estatísticas descritivas e representações gráficas, além de gerar informações úteis para a interpretação dos resultados.
O principal aprendizado foi compreender que a qualidade da análise estatística depende diretamente da qualidade dos dados. A base apresentou problemas de digitação, falta de padronização, valores ausentes e registros tecnicamente suspeitos, demonstrando a importância de realizar uma inspeção criteriosa antes das análises. Como melhoria, recomenda-se maior padronização durante a coleta e o preenchimento das planilhas, utilização de campos com validação e conferência dos registros antes de sua consolidação.
Em comparação com a Base R, o tidyverse proporciona um fluxo de trabalho mais integrado e sequencial, utilizando funções como filter(), mutate(), group_by() e summarise(), o que favorece a organização e a compreensão do código.
Para o tratamento da base, optou-se por preservar os dados originais e criar o objeto dados_limpos. Inconsistências com correção claramente identificável foram padronizadas, enquanto valores ausentes foram mantidos como NA e registros suspeitos foram sinalizados para conferência, evitando alterações sem justificativa.
Entre as principais funções utilizadas destacam-se `read_csv2()`, `glimpse()`, `filter()`, `mutate()`, `summarise()`, `group_by()`, `across()`, `case_when()`, `str_trim()`, `str_to_upper()`, `str_replace_all()`, `parse_double()` e `ggplot()`.
A solução adotada mostrou-se adequada por proporcionar organização, rastreabilidade e maior confiabilidade ao processamento, demonstrando que a limpeza dos dados constitui uma etapa essencial antes da aplicação de métodos estatísticos e da tomada de decisões na Engenharia Civil.
## 📖 Referências